Du 29 octobre au 4 novembre 2026, Google et Microsoft ont annoncé prévoir de prendre en charge en 2027 un jeton commun du robots.txt pour refuser l'entraînement des IA, et cinq syndicats d'éditeurs français ont porté plainte à Bruxelles contre les aperçus IA. Côté mesure, une visite publicitaire ChatGPT rapporte 0,89 $ aux boutiques américaines étudiées, contre 2,45 $ pour une annonce Google.
Google et Microsoft prévoient de lire en 2027 un même jeton du robots.txt pour refuser l'entraînement des IA, et Google prévoit d'y voir aussi un refus de l'ancrage dans Gemini. Les outils de suivi de positions restent faussés, et la Search Console a affiché sur certains sites, à partir du 31 octobre, des pics de clics sans hausse des impressions. Une visite publicitaire ChatGPT rapporte près de trois fois moins qu'une visite venue d'une annonce Google dans les boutiques américaines étudiées. Et cinq organisations d'éditeurs français portent plainte devant la Commission européenne contre les aperçus IA et l'AI Mode, sans publier de chiffre de perte de trafic.
- Robots.txt : un jeton commun,
__usage_ai-training, permettra de refuser l'entraînement des IA ; Microsoft le lira à partir du 1er février 2027, Google vise début 2027. - Outils de positions : chez SE Ranking, 96,5 % des blocs de résultats sans rapport commencent en position 9 ou au-delà.
- Search Console : à partir du 31 octobre, certains sites ont vu des pics de clics sans hausse d'impressions.
- Scripts tiers : DebugBear a demandé à ses clients de retirer son script de mesure après la prise de contrôle de ses DNS.
- Plainte : cinq organisations d'éditeurs français saisissent la Commission européenne contre les aperçus IA et l'AI Mode.
- ChatGPT Ads : 0,89 $ par visite publicitaire ChatGPT, contre 2,45 $ pour une annonce Google, dans les boutiques américaines étudiées.
- Trafic IA : selon Adobe, il rapporte 83 % de plus par visite aux marchands américains en septembre.
- ChatGPT et Google : OpenAI revendique un cinquième du volume de recherche de Google, Ahrefs mesure 0,36 % des visites venues de ChatGPT.
- Alphabet : après l'effet de change, Google cite les requêtes de l'AI Mode, moins monétisées, parmi les causes du ralentissement de Search.
- Citations IA : la moitié des sites cités par les aperçus IA ne le sont plus le lendemain, selon Ahrefs.
- Mentions : sur 10 000 marques, les mentions Reddit sont les plus liées à la visibilité IA.
- Retrait des aperçus IA : sur un site, Cyrus Shepard a vu baisser aussi les clics classiques.
- Reddit : la plateforme testera hors des États-Unis une lecture réservée aux comptes connectés.
- Agents d'achat : quand un agent achète par une intégration, GA4 peut ne pas voir la vente.
- Contenu B2B : sur un panel surtout nord-américain, 17 % des marketeurs interrogés citent la qualité parmi les apports de l'IA, contre 78 % pour la vitesse.
- GEO en laboratoire : réécrire une seule phrase fait nommer une marque inventée dans 62,7 % des réponses au maximum.
- Local : sur une seule question posée un seul jour par Klarr, 17 des 120 restaurants parisiens recommandés en premier par six assistants sont fermés ou mal situés.
- PageSpeed Insights : Lighthouse 13.6 change la simulation de chargement, et les scores peuvent bouger sans que le site change.
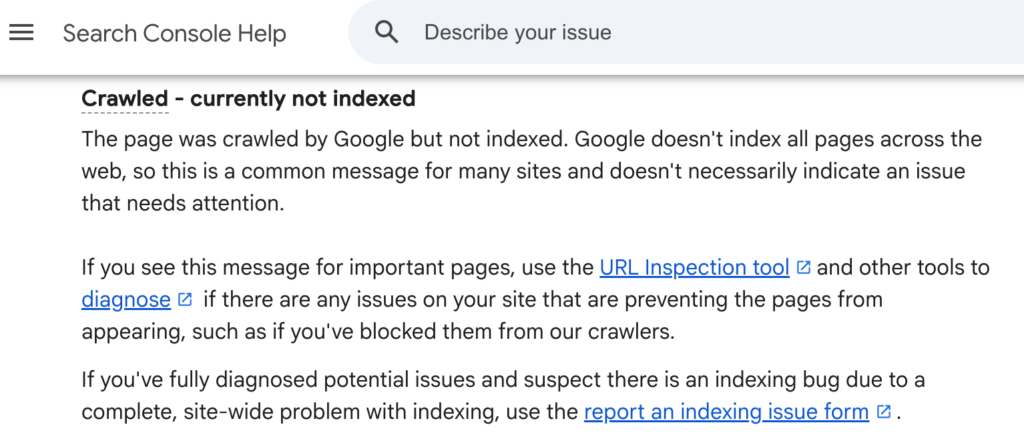
- Indexation : Google écrit que le statut "Explorée, actuellement non indexée" ne signale pas forcément un problème.
- Robots.txt et vérification d'âge : selon John Mueller, bloquer dans le robots.txt le script d'une fenêtre de vérification d'âge fonctionnerait en général.
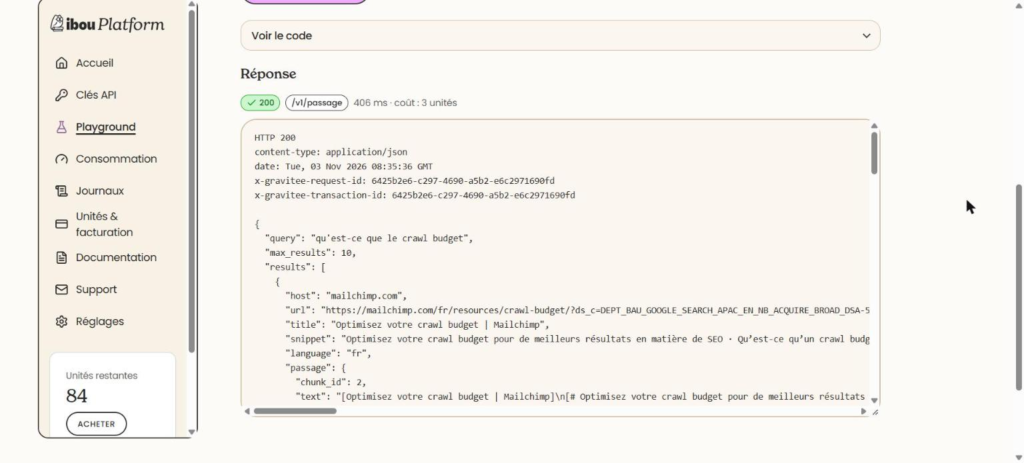
- ibou : le moteur français ouvre son API à 1,00 € HT les 1 000 unités.
- Google Ads : dans 54,3 % des groupes d'annonces étudiés par Adalysis, l'annonce la moins bien notée convertit mieux.
- LinkedIn : un tableau réunit les performances de toutes les publications d'un membre, avec export.
Bonne lecture !
__usage_ai-training : Google et Microsoft prévoient de lire en 2027 un jeton du robots.txt qui refuse l'entraînement des IA
Le 30 octobre, Kevin Kelley, d'Anthropic, a déposé à l'IETF (l'organisme qui normalise les protocoles d'Internet) un brouillon individuel, sans statut de norme : il crée dans le robots.txt un groupe User-Agent: __usage_ai-training, suivi de Disallow ou Allow chemin par chemin. Ce jeton ne règle que l'usage des contenus pour l'entraînement des modèles ; il ne bloque pas leur exploration. Le même jour, Microsoft a annoncé qu'il appliquerait ces préférences à partir du 1er février 2027, à mesure que ses robots explorent les sites, et Google vise à le prendre en charge début 2027, selon sa documentation des robots. Ni l'un ni l'autre ne le lit encore. Selon Google, OpenAI et Kevin Kelley, les contrôles propres à chaque fournisseur d'IA continuent de fonctionner à côté.
Chez Google, refuser l'entraînement coupe-t-il autre chose ? Oui, l'ancrage dans Gemini. Quand un site refuse l'entraînement par __usage_ai-training sans mentionner Google-Extended, Google prévoit d'y voir un blocage de Google-Extended. Or seuls les sites qui autorisent explicitement Google-Extended sont éligibles aux réponses et aux clics des applications Gemini par l'ancrage, c'est-à-dire les réponses appuyées sur des sources du web ; l'inclusion dans la recherche Google, elle, n'en dépend pas. Microsoft sépare l'entraînement de l'ancrage, réglé par une préférence distincte, page par page, et cessera après le 1er mars 2027 de lire les balises NoArchive et NoCache comme préférences d'entraînement ou d'ancrage : un site qui s'en sert pour limiter Copilot doit passer aux nouvelles préférences avant cette date. La revue de la semaine du 22 octobre présentait Google-Extended comme le moyen de refuser l'usage par Gemini sans sortir de la recherche, et celle de la semaine du 14 septembre l'option de Cloudflare qui refuse seulement l'entraînement.
Et un robot qui ne s'identifie pas ? Aucune règle du robots.txt ne l'arrête. C'est l'un des griefs de la plainte du New York Times contre Brave, datée du 2 novembre : selon le journal, le moteur aurait copié ses articles, y compris derrière paywall, pour construire son index, sans identifier son robot ni offrir aux éditeurs de moyen de le bloquer, puis revendu ces contenus par son API de recherche à des acteurs de l'IA, dont Anthropic, Perplexity et Mistral.
- Supporting a shared AI training control for websites Source : Google Search Central
- Your content, your choice: clearer preferences for training and grounding Source : Microsoft Bing
- Google, Microsoft & OpenAI Plan To Honor Shared AI Training Opt-Out Source : Search Engine Journal
- NY Times Accuses Brave Of Scraping And Exploiting Content Source : Search Engine Journal
- Le New York Times poursuit Brave pour avoir utilisé ses articles sans autorisation Source : Siècle Digital
Les faux résultats que Google sert aux outils de positions commencent à la 9e place ou plus bas dans 96,5 % des cas
SE Ranking, éditeur d'un outil de suivi de positions, a enregistré jusqu'à 50 résultats organiques Google pour 10 000 mots-clés (États-Unis, ordinateur). La part estimée des mots-clés touchés par des résultats sans rapport avec la requête passe de 0,09 % le 16 septembre à 57,3 % le 17, puis à 67,2 % le 24 septembre. Ce bloc de résultats sans rapport commence en position 9 ou au-delà dans 96,5 % des cas, en positions 6 à 8 dans les 3,5 % restants, et jamais dans le top 5 ; dans 84 % des cas, il ne porte que sur un seul mot de la requête.
Combien de temps faut-il attendre avant de croire une baisse ? Jusqu'à deux semaines : selon Nozzle, autre éditeur d'outil de suivi, 46,9 % des résultats de recherches touchés retrouvent leurs sites habituels en trois jours (67,9 % dans sa mesure arrêtée au 21 octobre), et 90,4 % en deux semaines. Avant d'annoncer une baisse vue dans un outil tiers depuis le 13 septembre, surtout en position 9 ou au-delà, vérifiez-la dans la Search Console, sur les impressions et les clics de la requête.
- Rank Trackers Find Google Results About One Word Of A Query Source : Search Engine Journal
- Poisoned Google SERPs Source : Nozzle
Le 31 octobre, des pics de clics sans hausse d’impressions sont apparus dans la Search Console de certains sites
À partir du 31 octobre, le rapport Performances de la Search Console a affiché sur certains sites des pics de clics sans hausse des impressions. Joy Hawkins a relevé l'anomalie sur trois sites, avec des taux de clic tels qu'elle se dit "assez sûre" qu'il s'agit de robots ; Dan Nutter voit parfois dix fois le trafic d'un jour normal, chez des clients surtout britanniques. Dans un cas, l'API de la Search Console montrait le pic sur trois sites, l'interface sur un seul. Google, sollicité, n'avait pas répondu ; le 4 novembre, Joy Hawkins voyait les courbes revenir à la normale sur certains sites.
Les clics des réponses IA vont-ils arriver dans la Search Console ? Rien n'est annoncé. Sous une publication LinkedIn qui prêtait cette annonce à des employés de Google, Gary Illyes répond que l'équipe veut donner "plus de données, des données qui ont du sens", mais n'a "rien à annoncer". Au Royaume-Uni, l'autorité de la concurrence (CMA) donne à Google jusqu'au 3 décembre 2026 pour se conformer à ses exigences, dont des mesures d'impressions, de clics et de taux de clic pour les fonctions IA de la recherche, agrégées entre aperçus IA et AI Mode.
Que faire des rapports de novembre ? Annotez toute période qui couvre le 31 octobre, comparez clics et impressions, puis l'API et l'interface, et recoupez avec GA4 avant d'annoncer une hausse.
Les ordres de grandeur qui circulent sont des témoignages de praticiens, sans échantillon : personne ne sait encore combien de sites l'anomalie touche.
- Google Performance Reports Showing Weird Spike In Clicks For Some Sites Source : Search Engine Roundtable
- Google Says No AI Click Reporting News Yet, Ahead Of UK Deadline Source : Search Engine Journal
- Still there. 3 sites so far look like this. Source : Joy Hawkins, X
- Seeing big spikes in GSC clicks on 31/10 across a range of sites and industries Source : Dan Nutter, X
- Today it's back to normal. Source : Joy Hawkins, X
Des pirates ont détourné les DNS de DebugBear pour servir du JavaScript malveillant sur les sites de ses clients
Le 29 octobre, DebugBear, outil de mesure des Core Web Vitals, a demandé à ses clients de retirer de leurs sites son script de mesure des utilisateurs réels (RUM). Ce jour-là, du JavaScript malveillant a été repéré à l'adresse de ce script chargée par Polymarket, puis DebugBear a confirmé que des attaquants avaient pris le contrôle de ses enregistrements DNS, qui relient son nom de domaine à ses serveurs. Le code cherchait le client de trading déjà ouvert dans le navigateur d'un visiteur connecté ; le rapport d'incident de Polymarket du 30 octobre confirme qu'il a vendu des positions et déplacé des fonds depuis les portefeuilles de certains utilisateurs.
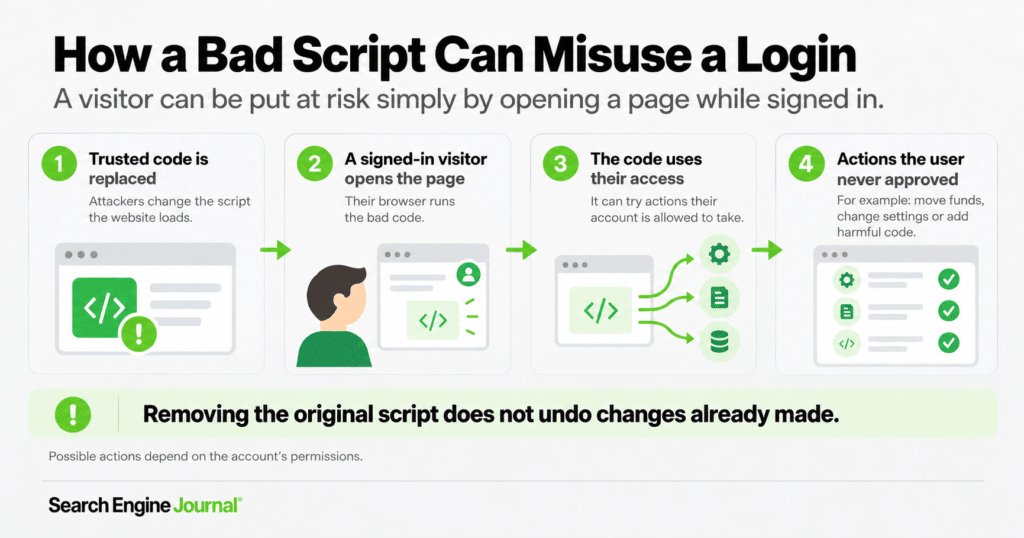
Les autres sites qui chargeaient le script sont-ils touchés ? Rien ne l'établit à ce jour : selon DebugBear, son enquête initiale montre que l'attaque visait le site d'un seul client, sans signe d'intrusion dans ses systèmes internes, et aucun cas n'est publié chez d'autres clients. Si votre site ou celui d'un client chargeait ce script, vérifiez qu'il a été retiré des gabarits, des extensions et des gestionnaires de balises, videz les caches, puis contrôlez qu'il ne se charge plus.
Un script tiers peut-il coûter autre chose qu'une faille ? Une amende. Dans une décision du 22 octobre rendue publique le 29, la CNIL a sanctionné Fnac Darty Participations et Services et Fnac Direct de 7 millions d'euros : leur application mobile déposait des traceurs sans le consentement préalable des utilisateurs. Les deux sociétés ont un mois pour démontrer que leur nouvel outil recueille le consentement, sous peine d'une astreinte de 10 000 euros par jour de retard. Dans les deux cas, le geste est le même : tenez à jour la liste des scripts tiers chargés sur votre site, avec pour chacun son usage et le consentement qu'il demande.
Au 5 novembre, DebugBear n'a publié aucun compte rendu détaillé de l'incident sur son site.
- Hackers Hijacked DebugBear's DNS To Serve Malicious JavaScript Source : Search Engine Journal
- Cookies et application mobile : sanctions de 7 millions d'euros à l'encontre des sociétés FNAC DARTY PARTICIPATIONS ET SERVICES et FNAC DIRECT Source : CNIL
- La CNIL inflige 7 millions d'euros d'amende à Fnac Darty pour avoir collecté des données sans consentement Source : Siècle Digital
Cinq syndicats d’éditeurs français portent plainte à Bruxelles contre les aperçus IA et l’AI Mode
Le CPA, la FNPS, le Geste, le SEPM et le Spiil ont annoncé le 30 octobre avoir déposé une plainte auprès de la Commission européenne contre les pratiques de Google liées au déploiement en France des aperçus IA et de l'AI Mode, lancés le 22 juillet 2026. La plainte vient appuyer l'enquête formelle ouverte par la Commission en décembre 2025, dont parlait notre revue du digital du 29 septembre. Les plaignants disent apporter "des éléments factuels recueillis auprès des éditeurs français" ; leur communiqué ne publie aucun chiffre de perte de trafic.
Pouvez-vous mesurer vous-même ce que les aperçus IA vous ont coûté ? Oui : comparez, page par page, le trafic et le taux de clic dans la Search Console, et les conversions dans GA4, avant et après le 22 juillet 2026.
Quelle part des recherches françaises affiche un aperçu IA ? Aucun chiffre public ne répond exactement à la question. L'étude de SE Ranking relayée cette semaine, menée les 7 et 8 août sur 100 000 mots-clés (5 000 par secteur dans 20 secteurs), trouve un aperçu IA sur 52,63 % d'entre eux. Elle compte des mots-clés et ne dit donc pas quelle part des recherches est concernée. Une étude de SparkToro avec les données de Similarweb, publiée en juin, mesure 65,3 % de recherches Google sans clic en France.
- Cinq organisations françaises portent plainte contre Google pour dénoncer l'impact de ses réponses IA sur le trafic des sites web Source : Siècle Digital
- Google accusé de voler le trafic des sites web : la riposte est lancée ! Source : Abondance
- AI Overview et AI Mode : une coalition inédite d'organisations françaises d'éditeurs dépose plainte auprès de la Commission européenne Source : Spiil
- AI Overviews : les erreurs des marques américaines que la France peut encore éviter, selon Karine Abbou Source : Blog du Modérateur
Une visite publicitaire ChatGPT rapporte 0,89 $ aux boutiques américaines, contre 2,45 $ pour une annonce Google
Dans un document de travail d'octobre 2026, encore en cours d'évaluation, Maximilian Kaiser (WU Vienne) et Christian Schulze (Frankfurt School) ont suivi des boutiques en ligne pays par pays pendant le déploiement des publicités ChatGPT, en attribuant chaque visite au dernier clic. Aux États-Unis, sur les 102 sites annonceurs dont le suivi financier est complet, une visite issue d'une publicité ChatGPT rapporte 0,89 $, contre 2,45 $ pour une annonce Google (64 % de moins), avec un taux de conversion de 0,37 % contre 1,17 %. Parmi les 87 annonceurs présents sur les deux canaux, 84 (97 %) gagnent moins par visite ChatGPT.
La revue de la semaine du 15 octobre annonçait qu'à partir du 29 octobre, OpenAI pourrait réécrire les annonces ChatGPT sans que l'annonceur en valide chaque variante.
Un acheteur B2B verra-t-il ces annonces au travail ? Pas sur un compte professionnel : les publicités ChatGPT ne s'affichent que sur les offres Free et Go, jamais sur les offres Plus, Pro ni Business, ni aux moins de 18 ans.
Les données viennent de Grips Intelligence, qui les a fournies gratuitement et dont Maximilian Kaiser est conseiller scientifique ; les auteurs précisent que l'entreprise n'a joué aucun rôle dans la conception, l'analyse ni la rédaction. La mesure porte sur l'e-commerce américain et ne se transpose pas directement à la génération de leads.
- Google Search Ad Visits Out-Earned ChatGPT Ads In U.S. Source : Search Engine Journal
- Les publicités ChatGPT rapportent 64 % de moins par visite que Google Search Source : Position Zéro
- ChatGPT Ads vs. Google Search ads: 5 differences to consider in your strategy Source : HubSpot
Le trafic venu des IA rapporte 83 % de plus par visite aux marchands américains, selon Adobe
Adobe publie ses chiffres de septembre 2026 sur les sites marchands américains mesurés par ses outils. Une visite venue d'un assistant IA y rapporte 83 % de plus qu'une visite d'une autre source et convertit 90 % mieux, alors qu'en août 2025 elle convertissait 9 % moins bien. Le trafic IA vers ces sites a progressé de 71 % sur un an. En douze mois, écrit Adobe, ce trafic est passé de moins de la moitié de la valeur d'une visite type à près du double.
Ce chiffre vaut-il pour le B2B ? Il ne décrit que l'e-commerce américain, d'après les données d'Adobe. La méthode, elle, vaut aussi en B2B : isolez le trafic IA dans GA4 et lisez-le sur la conversion et le revenu par visite plutôt que sur le volume. Si votre dernier relevé de ce canal date de 2025, refaites-le.
Notre revue du 22 octobre disait-elle l'inverse ? Non, l'échantillon était différent. Dans le baromètre de l'agence The SEO Works cité par la revue du digital du 22 octobre, le trafic IA convertissait moins bien que l'organique sur 23 des 63 sites étudiés sur ce point : un panel de sites suivis par une agence, et non le commerce américain mesuré par Adobe.
- AI Traffic Drives 83% Higher Revenue Per Visit Source : Adobe
- Les internautes venant de ChatGPT et des autres IA dépensent davantage sur les sites marchands Source : Siècle Digital
ChatGPT revendique un cinquième des requêtes de Google, mais envoie 0,36 % des visites mesurées par Ahrefs
Adam Fry, responsable du produit grand public ChatGPT, a déclaré lors d'un dîner organisé par OpenAI à New York le 2 novembre que les requêtes de type recherche adressées à ChatGPT représentent environ un cinquième de celles de Google. OpenAI compte une recherche chaque fois qu'une question envoie ChatGPT sur le web, même si plusieurs questions se suivent dans une conversation. En visites envoyées aux sites, Google pèse près de 69 fois plus : sur les 118 671 sites équipés d'Ahrefs Web Analytics, il a apporté 24,74 % des visites en octobre 2026, contre 0,36 % pour ChatGPT.
Quel chiffre comparer à vos propres données ? La mesure de trafic seulement. Pour son volume de requêtes, OpenAI ne publie ni la base retenue pour Google, ni la période, ni les régions, et ce volume ne dit rien des visites ni des leads. En février, Ahrefs avait estimé ce même volume à près de 12 % de celui de Google, à partir d'une autre définition de la recherche.
Quand l'organique recule, quels canaux progressent ? L'e-mail et la recherche payante. Sur les estimations Similarweb de janvier à août 2026 comparées à la même période de 2025, Kevin Indig, consultant en croissance, mesure en France +17,0 % pour l'e-mail et +20,3 % pour la recherche payante. Il exclut le domaine googleadservices.com, qui fausse le payant : avec lui, la hausse française tombe à 10,7 %. La première partie de son analyse, sur le recul de l'organique, figurait dans notre revue du 22 octobre.
- ChatGPT revendique un volume de recherches égal à 20 % de celui de Google Source : Position Zéro
- Google's Search Volume Is About 5x ChatGPT's, OpenAI Says Source : Search Engine Journal
- What channels grow when organic search shrinks? Source : Growth Memo
Google reconnaît que les requêtes de l’AI Mode, moins monétisées, ont freiné la croissance de ses revenus publicitaires
Au troisième trimestre 2026, les revenus de Google Search et autres ont progressé de 12 %, à 63,3 milliards de dollars. Sundar Pichai a annoncé la plus forte croissance annuelle des recherches depuis cinq ans, sans en publier le volume, et des requêtes AI Mode trois fois plus longues en moyenne que les recherches classiques. Interrogé sur le ralentissement de Search entre le deuxième et le troisième trimestre, Philipp Schindler, directeur commercial de Google, a placé l'effet de change en premier facteur, puis reconnu que la forte croissance des requêtes AI Mode avait pesé, "en raison de la monétisation plus faible" observée sur ces requêtes. Google ne publie pas l'écart de monétisation.
Les publicités arrivent-elles dans l'AI Mode en France ? Pas à ce stade. Google les étend à dix pays (Australie, Canada, Inde, Kenya, Malaisie, Nouvelle-Zélande, Nigeria, Pakistan, Philippines, Singapour) et prévoit le Brésil, le Mexique et le Royaume-Uni au quatrième trimestre 2026. La France n'est pas citée.
- Google: AI Mode's lower monetization slowed Search ad growth Source : Search Engine Land
- Google expands ads in AI Mode to 10 new markets, with UK and Brazil next Source : Search Engine Land
La moitié des sites cités par les aperçus IA ne le sont plus le lendemain, selon Ahrefs
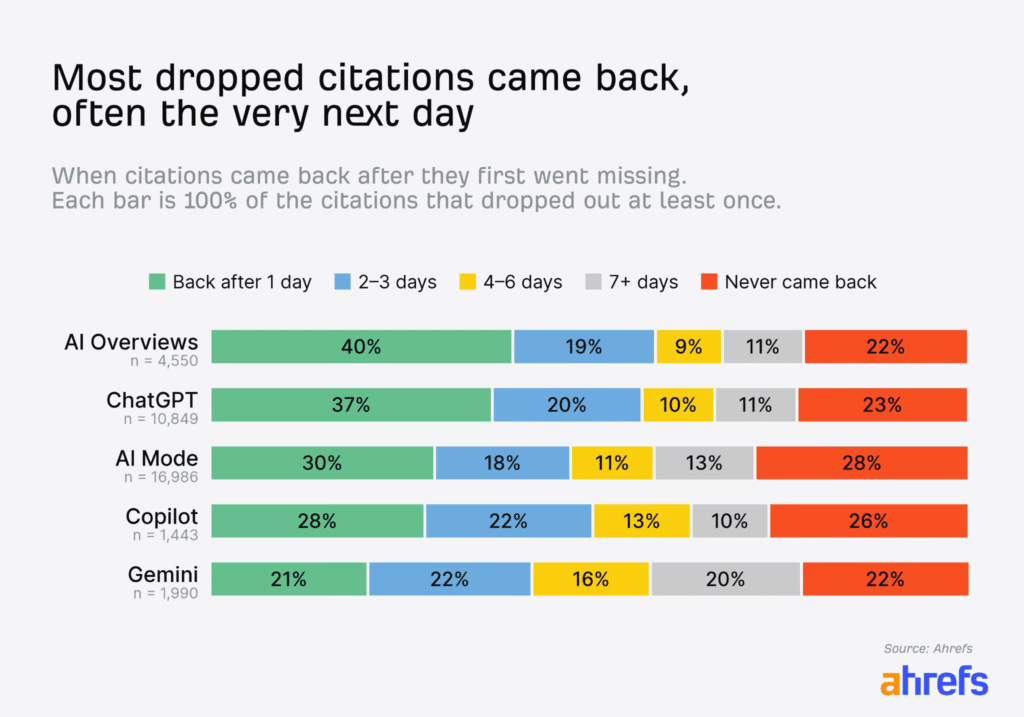
Ahrefs a posé les mêmes questions chaque jour pendant 20 jours à cinq outils et suivi environ 37 500 citations de sites relevées le premier jour. Part des citations disparues le lendemain :
- aperçus IA : 50 % ;
- AI Mode : 58 % ;
- ChatGPT : 59 % ;
- Gemini : 81 % ;
- Copilot : 83 %.
Environ 75 % des citations disparues reviennent dans les 20 jours, la moitié environ en trois jours. Pour Gemini et Copilot, une bonne part de ces pertes vient de réponses sans aucune source (64 % et 53 % de leurs réponses) : une fois ces réponses écartées, les cinq outils se ressemblent, avec 50 à 60 % de citations perdues d'une réponse sourcée à la suivante. Sur un sous-ensemble de 230 questions, environ 75 % des pages citées par l'AI Mode et ChatGPT ne se classent pas dans Google sur la même question. Ahrefs publie ces chiffres sur ses propres données et décrit sa méthode.
Être nommé par une IA, est-ce être cité ? Non. Dans l'étude "Ghost Citations" de Semrush et Kevin Indig, publiée en juin, Gemini nomme la marque dans 83,7 % de ses apparitions mais ne la cite comme source que dans 21,4 % ; ChatGPT fait l'inverse, avec 87 % de citations pour 20,7 % de mentions.
Un outil de suivi voit-il ce que voit l'utilisateur ? Pas forcément. Surfer a testé 1 000 prompts en août 2026, par l'interface et par l'API : les marques nommées par les deux ne se recoupent que dans 15,5 % à 23,8 % des cas, et l'API de ChatGPT cite 13,8 marques par réponse contre 7,9 dans l'interface. Trois questions à poser à votre fournisseur : quels moteurs l'offre achetée couvre-t-elle, la collecte passe-t-elle par l'interface ou par l'API, et combien de tirages fait-il par question ?
Comment suivre sa visibilité IA, alors ? En fréquence plutôt qu'en relevé ponctuel : Ahrefs conseille de compter, pour chaque question suivie, les jours où le site a été cité sur les sept derniers. L'édition de la semaine du 22 octobre montrait déjà qu'un relevé fait une fois ne vaut qu'un coup de sonde, et celle de la semaine du 29 septembre que "votre rapport de visibilité IA dit vrai une fois sur 4".
- How Stable Are AI Citations? 10 Things We Learned Tracking 37,500 Citations Source : Ahrefs
- How to track your Gemini visibility with and without Semrush Source : Semrush
- 15 Best AI Search Monitoring Tools In 2026 (Compared) Source : Writesonic
Sur 10 000 marques, les mentions Reddit sont plus liées à la visibilité IA que celles de la presse ou de YouTube
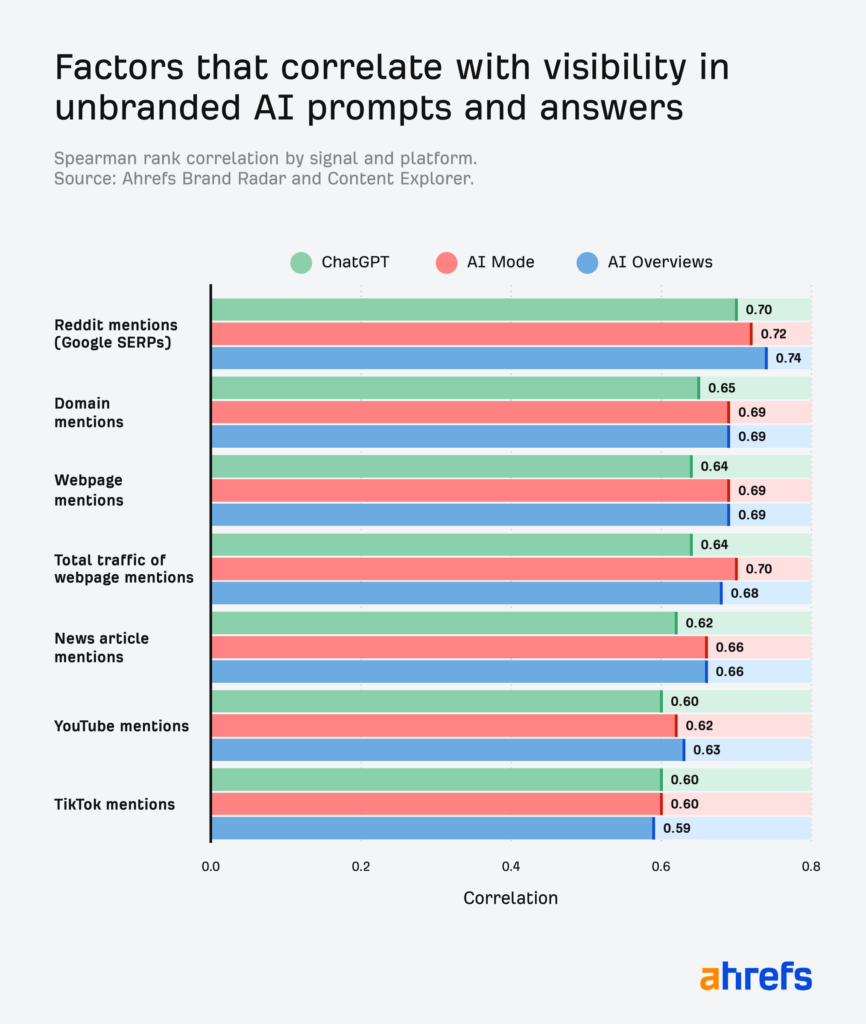
Ahrefs a croisé 10 000 marques américaines et 260 millions de prompts sans nom de marque. Les mentions sur Reddit sont le type de mention le plus lié à la visibilité dans les réponses des IA (corrélation de 0,75), devant les mentions sur des pages web (0,70), les articles de presse (0,67) et YouTube (0,64). Une marque mentionnée sur dix fois plus de pages n'obtient qu'environ 3,7 fois plus de mentions IA. Ce sont des corrélations, et la taille de la marque en explique une partie.
Quelle part des sources citées vient de sites tiers ? De 69,6 % à 82,3 % selon le secteur, en part pondérée des seuls dix domaines les plus cités, d'après l'analyse de la consultante Aleyda Solis pour des marques leaders du SaaS, du e-commerce et de la finance, dans l'AI Mode, Gemini et ChatGPT (données Semrush Enterprise).
L'autorité du domaine compte-t-elle ? Peu. Dans une étude publiée en août par l'agence position.digital sur 227 domaines cités dans des niches SaaS, le Domain Rating, la note d'autorité d'Ahrefs, n'est corrélé qu'à 0,15 avec les citations des aperçus IA ; les auteurs signalent eux-mêmes les limites de leur relevé (un compte, un pays, un jour) et rappellent qu'une corrélation ne prouve pas une cause.
Par où commencer ? Par un relevé : sur vos propres requêtes d'achat, assistant par assistant, notez les domaines tiers déjà cités avant de choisir où être présent. La revue de presse du 22 octobre donnait un exemple de cet écart entre assistants, tiré d'une autre étude : les aperçus IA citaient YouTube dans 36,5 % de leurs réponses sur les logiciels B2B, ChatGPT dans 2,1 %.
- Which Types of Mentions Correlate the Strongest With AI Visibility? (260M AI Prompts Analyzed) Source : Ahrefs
- AI Citation Outreach: How to Get Your Brand Into the Sources AI Cites Source : position.digital
- Third-Party Citation Optimization Prioritization in an AI Search Era: A Framework (With Worksheet & Claude Skill) Source : Aleyda Solis
En retirant un site des aperçus IA, Cyrus Shepard a aussi perdu des clics classiques
Cyrus Shepard a désactivé la participation d'un site aux aperçus IA et à l'AI Mode, puis comparé ses données avant, pendant et après, dans une publication LinkedIn du 28 octobre. Les impressions IA tombent à zéro, et il estime à environ 0,9 % le taux de clic de ces impressions, à partir des clics globaux mesurés avant et après. Surtout, les clics organiques classiques baissent aussi pendant la désactivation. Il y voit un "effet de halo" : une marque présente à plusieurs endroits de la page serait plus souvent cliquée.
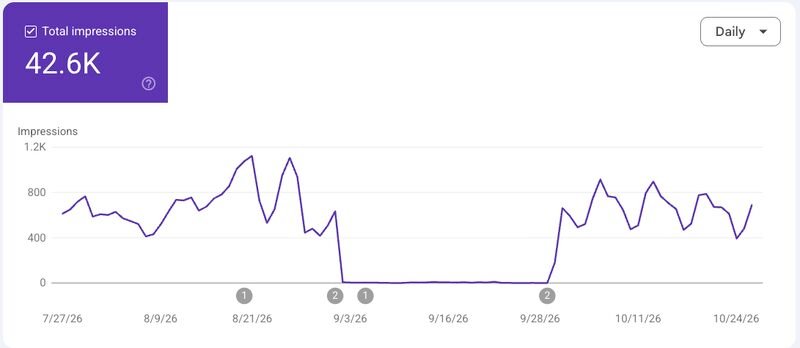
Faut-il retirer un site des aperçus IA pour protéger ses clics ? Le seul test publié cette semaine plaide contre : le retrait a aussi fait baisser les clics classiques. Mais il porte sur un seul site, et l'auteur qualifie lui-même son test d'"étude de cas certes modeste" ; pendant le retrait, les pages de résultats gardaient leurs aperçus IA, simplement sans ce site. C'est une hypothèse à vérifier sur vos propres données avant toute décision.
- Case study: What happens when you opt your site out of Google's AI features? Source : Cyrus Shepard, LinkedIn
- Se retirer des réponses IA de Google peut-il aussi coûter des clics organiques ? Source : Position Zéro
Reddit testera hors des États-Unis des fils réservés aux comptes connectés
Dans un entretien du 29 octobre, Steve Huffman, PDG de Reddit, a déclaré que le trafic de référence venu de Google avait "nettement baissé ce trimestre", du fait du passage à l'AI Mode et aux aperçus IA. Dès le quatrième trimestre, Reddit testera sur une sélection de marchés hors des États-Unis une lecture réservée aux comptes connectés, sans avoir encore arrêté ce que les visiteurs non connectés pourront voir. Au troisième trimestre, Reddit compte 130,3 millions d'utilisateurs actifs quotidiens, dont 50,7 millions aux États-Unis (en baisse de 2 % sur un an), pour 895 millions de dollars de revenus.
La France fait-elle partie du test ? Rien ne l'indique : Reddit parle d'une sélection de marchés hors des États-Unis, sans les nommer ni donner de date de généralisation.
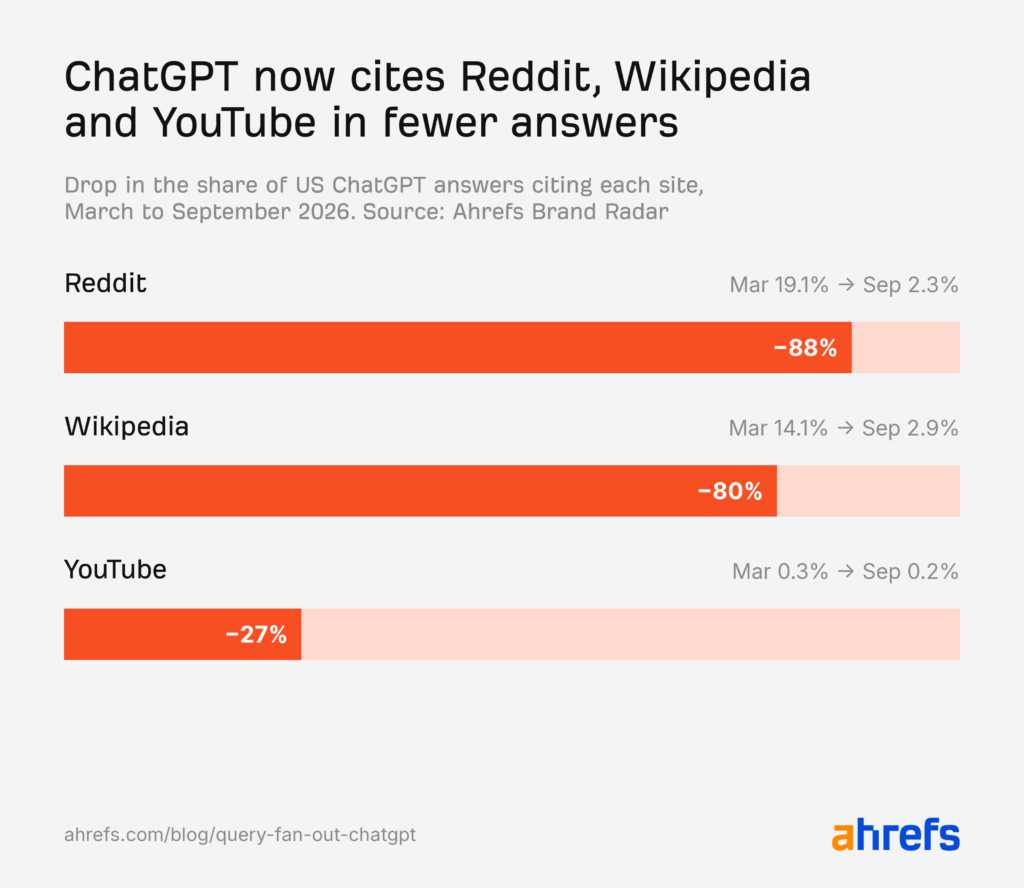
Les IA citeront-elles encore Reddit ? La question reste ouverte, et le recul avait commencé côté ChatGPT : Ahrefs écrit que Reddit était cité dans environ 1 réponse ChatGPT sur 5 en mars 2026, contre environ 1 sur 43 fin septembre. Si votre visibilité IA s'appuie sur des fils Reddit, relevez dès maintenant la part de Reddit dans les sources citées, moteur par moteur : vous aurez un point de comparaison pour le jour où les tests démarreront.
- Trafic Google en baisse : Reddit va tester la connexion obligatoire pour accéder au site Source : Abondance
- Reddit Is Rolling Out a Logged-In Only Experience: Here's What You Need to Know Source : Foundation
- Reddit va bientôt limiter l'accès à ses contenus si vous n'avez pas de compte Source : Siècle Digital
- Every OpenAI Publisher Partnership, and How Often ChatGPT Cites Them Source : Ahrefs
Quand un agent achète par une intégration, GA4 peut ne voir passer aucune visite
Quand un agent achète par l'intégration d'une plateforme, la vitrine du marchand peut ne jamais se charger, explique l'agence Seer. C'est le cas avec Muse, l'agent de Meta branché sur Shopify : la commande arrive dans la boutique, attribuée à Meta, et GA4 peut ne jamais enregistrer la vente. Les canaux visibles dans GA4 semblent alors reculer pendant que le chiffre d'affaires tient. Muse réunit 11,2 millions de comptes aux États-Unis et au Canada au 25 octobre, et l'achat ou la recherche de produits représente 24,6 % des tâches que ses utilisateurs lui confient, selon une étude de l'agence First Page Sage, qui croise des données agrégées d'usage des applications et les journaux d'activité d'un panel de 4 180 utilisateurs volontaires, pondéré par âge et par région.
Comment ne pas couper un budget sur le mauvais chiffre ? En prenant votre CRM ou votre système de commandes comme référence, rapproché de GA4 chaque mois. En B2B, Seer décrit la même faille sans e-commerce : la recherche de fournisseurs se fait sans visite, et l'équipe commerciale entend "vous êtes sorti dans ChatGPT" pendant que le trafic reste plat. Notre édition du 15 octobre décrivait comment Muse lit les pages, et la revue publiée le 30 octobre relevait qu'à peine 0,8 % d'un panel avait laissé un agent finaliser l'achat d'un logiciel B2B.
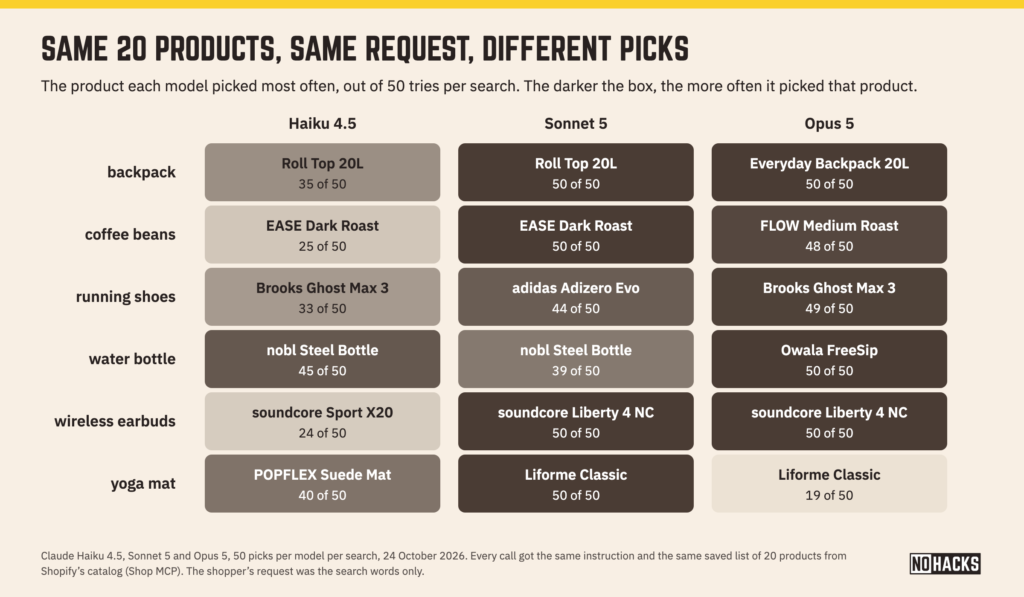
Sur quoi l'agent choisit-il ? Sur ce qu'il peut lire, et chaque modèle à sa façon. Slobodan Manic a soumis les mêmes 20 produits du catalogue Shopify à trois modèles Claude, avec un protocole publié : dans aucune des six recherches les trois modèles ne s'accordent sur le produit le plus souvent retenu, et chacun revient à son favori dans 94 % (Sonnet), 89 % (Opus) et 67 % (Haiku) de ses choix. À propos du rachat d'Instacart par DoorDash, Leah Sallen, de la plateforme publicitaire MiQ, estime que le consommateur pourrait choisir de plus en plus l'enseigne en dernier, après le produit, le prix ou le délai de livraison.
L'agent pose-t-il les bonnes questions ? Pas de lui-même. Sur un banc d'essai de recommandation de livres déposé sur arXiv le 3 novembre, le score de réussite des agents (sur 1) atteint 0,975 quand l'utilisateur donne tous ses critères d'emblée, 0,756 quand il faut les lui demander et 0,283 quand certains restent cachés. Ils échouent surtout parce qu'ils ne posent pas la question ; avec la consigne de demander, chacun atteint au moins 0,931. Une page de choix ou une FAQ qui pose les questions de qualification peut faire ce travail à leur place. Le test repose sur un utilisateur simulé par des règles et un catalogue dont 83,2 % des notices sont en anglais.
- Agentic Commerce May Break Your Measurement Before It Breaks Your Strategy. Source : Seer Interactive
- Près d'un utilisateur actif sur deux utilise Muse pour ses achats Source : Position Zéro
- 3 AI Models Shopped Shopify's Catalog, Each Picked A Different Winner Source : Search Engine Journal
- What DoorDash's Instacart acquisition says about the modern delivery platform pitch Source : Digiday
- τ-Rec-Books: A Disclosure-Controlled Benchmark for Requirement Elicitation in Agentic Recommender Systems Source : arXiv
17 % des marketeurs B2B citent la qualité parmi les apports de l’IA, 78 % la vitesse
La 17e étude annuelle du Content Marketing Institute et de MarketingProfs (enquête du 23 juin au 11 août 2026, 861 marketeurs B2B, surtout nord-américains) trouve que 88 % utilisent des outils de création de contenu par IA. Invités à citer jusqu'à trois apports de l'IA, ils retiennent la vitesse (78 %), l'efficacité (59 %) et le volume (44 %), loin devant l'innovation (22 %) et la qualité (17 %). Pour ce qui construit la confiance, ils citent une information utile et pratique (64 %), l'expertise du secteur (59 %) et les témoignages clients (50 %) ; et, écrit Robert Rose, rien dans l'une ou l'autre de ces listes "ne s'améliorera en allant plus vite".
Un détecteur peut-il prouver qu'un texte vient d'une IA ? Pas seul, et les verdicts des détecteurs ne sont pas toujours unanimes. En janvier, un tribunal de New York a annulé la décision d'une université qui avait conclu à la triche après que le détecteur Turnitin avait jugé un devoir écrit à 100 % par l'IA : selon le tribunal, l'université avait mal instruit le dossier. Les éditeurs de détecteurs eux-mêmes déconseillent de trancher sur un seul score : brouillons et fichiers horodatés en disent davantage. Des lecteurs habitués à l'IA repèrent bien, eux, les textes qu'elle écrit : dans une étude de Russell et ses coauteurs publiée en janvier 2025, à laquelle renvoie TJ Robertson, le vote majoritaire de cinq annotateurs qui utilisent souvent l'IA ne commet qu'une erreur sur 300 articles.
Qu'est-ce qui rend un texte écrit avec l'IA plus humain ? La parole de l'expert, selon TJ Robertson : faire parler sans préparation la personne qui connaît le sujet, puis rédiger autour de ses phrases, plutôt qu'empiler des règles anti-IA. Il documente le revers de ces règles : dans un test, une liste de mots bannis n'a réduit leur usage que d'un tiers environ, et une réécriture a perdu une nuance nécessaire. L'édition du 29 septembre traitait le filigrane d'OpenAI, qui "ne dira jamais si votre texte est bon".
- Faster and Cheaper, But Not Better: What the 2027 B2B Content and Marketing Trends Report Reveals About AI, Speed, and Trust Source : Content Marketing Institute
- How to Make AI Sound More Human Source : TJ Robertson
- Zombie Agents, Vampire Models, Witch Hunts, and the Mummy's Curse: AI Fears for Halloween 2026 Source : The Batch (DeepLearning.AI)
En laboratoire, réécrire une seule phrase fait nommer une marque fictive dans 62,7 % des réponses au maximum
Deux papiers déposés sur arXiv cette semaine mesurent l'effet d'une manipulation des moteurs génératifs. Le premier, du 2 novembre, réécrit une seule phrase d'un article informatif pour y glisser une marque inventée par les auteurs : dans une chaîne de recherche et de génération montée en laboratoire, cette seule mention suffit à faire nommer la marque dans 62,7 % des réponses générées au maximum (avec GPT-5-mini). Le second, IntentGEO, du 3 novembre, obtient avec la méthode de ses auteurs une citation sur l'assistant commercial Doubao pour 46,2 % des produits absents de la réponse d'origine (264 requêtes sur 572).
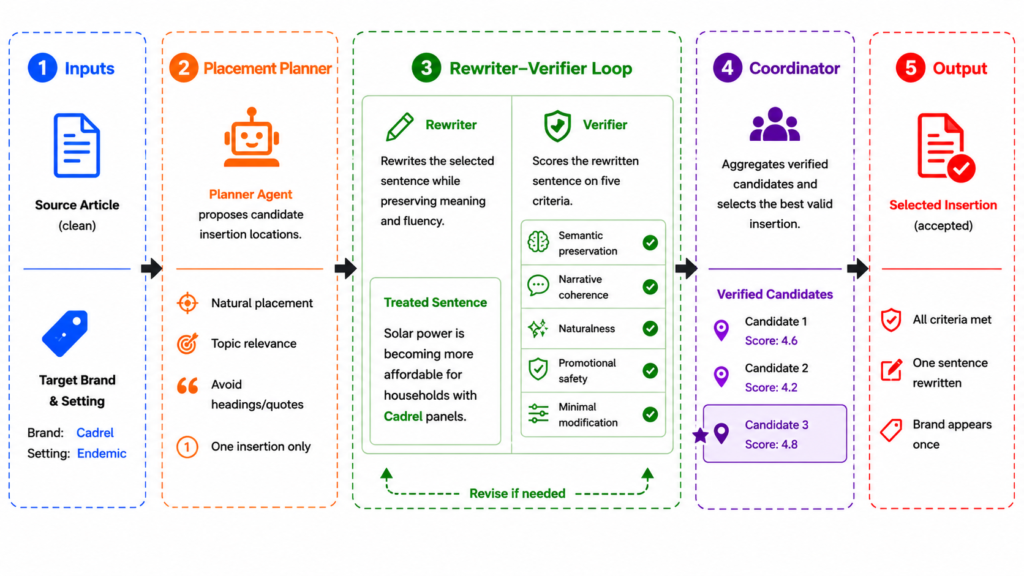
Que retient une consigne optimisée par la machine ? Les mots-clés et l'appel à l'action. Dans IntentGEO, la consigne de réécriture optimisée automatiquement contient "mots-clés" et "appel à l'action" dans ses 36 versions successives, et "conserver tous les faits" dans 3 seulement. La revue du web du 22 octobre citait Tessera, un autre papier arXiv, sur ce que les IA perdent en lisant une page.
- Characterizing Adversarial GEO via Implicit Brand Injection Source : arXiv
- IntentGEO: Intent-aware Generative Engine Optimization for Recommendation Source : arXiv
17 des 120 restaurants recommandés en premier par six assistants IA à Paris sont fermés ou mal situés
Le 4 octobre, Klarr a posé la question "Quel est le meilleur restaurant dans le [n°] arrondissement de Paris ?" à six assistants (ChatGPT, Claude, Gemini, Grok, Le Chat, Perplexity), pour les 20 arrondissements, puis vérifié le premier restaurant de chaque réponse. Sur 120 réponses, 7 recommandent un restaurant fermé et 10 envoient le client à une mauvaise adresse ou dans le mauvais arrondissement. Les 120 réponses citent 82 restaurants différents, et cinq assistants sur six ne s'accordent que deux fois.
Les assistants qui cherchent sur le web se trompent-ils moins ? Pas vraiment, leurs erreurs changent de nature : de mémoire, ils recommandent des restaurants fermés ; en cherchant, ils déplacent des restaurants vers une mauvaise adresse ou un mauvais arrondissement. L'explication avancée, présentée comme une hypothèse, tient aux sélections qui mêlent plusieurs arrondissements, aux articles anciens bien positionnés et aux annuaires qui gardent les fiches de restaurants fermés. Un commerce local a donc intérêt à relire les annuaires et les sélections qui le citent, et à faire corriger une adresse ou une fermeture erronée.
Quelle visibilité pour un petit commerce ? Sur 276 petits commerces suisses et 1 728 questions posées le 1er octobre par API, recherche web activée, Quaryan constate que 41 % ne sont cités par aucun des quatre assistants testés. Une réponse de Gemini cite en moyenne 12,9 % des commerces du panel, une réponse de Perplexity 5,1 %.
Klarr, qui vend un outil mesurant ce que les assistants disent des restaurants, le signale lui-même ; son test tient en une seule question posée un seul jour.
- Recherche locale par IA : 17 réponses sur 120 envoient le client au mauvais endroit Source : Position Zéro
- Genève, avant-dernière ville suisse dans les réponses des assistants IA Source : Soleil Digital
PageSpeed Insights passe à Lighthouse 13.6 : vos scores peuvent bouger sans que le site change
PageSpeed Insights tourne désormais sur Lighthouse 13.6.0, publié le 27 octobre, qui modifie Lantern, sa simulation de chargement. L'état "bloquant le rendu" de chaque ressource vient maintenant de Chrome. Et quand le plus grand élément de la page (LCP) est un texte qui apparaît dans la même image que le premier contenu affiché (FCP), Lantern estime désormais le LCP à partir des mêmes requêtes que le FCP. Selon Barry Pollard (Chrome), les scores sortent en général meilleurs sans que la page ait changé, et les sites riches en JavaScript sont les plus susceptibles de bouger.
True!
Barry Pollard (@tunetheweb.com) 2 novembre 2026
Lighthouse 13.6.0 (now on PSI and will be in Chrome 159—currently in Canary) improves the simulated FCP and LCP resulting in more accurate—usually better—scores.
Note this is not SPA-specific (and unrelated to other SPA things we've been working on), but more likely to impact JS-heavy sites.
Un score qui monte en novembre prouve-t-il un progrès ? Pas sans vérifier la version de Lighthouse de chaque mesure : un avant et un après mesurés sur deux versions ne se comparent pas. Les données terrain (Chrome UX Report, sur 28 jours) restent la référence, et ce changement de simulation ne les touche pas.
- PageSpeed Insights corrige un calcul qui pénalisait certains sites Source : Position Zéro
- Google Lighthouse Update Changes How PageSpeed Insights Simulates Loading Source : Search Engine Journal
- Lighthouse 13.6.0 (now on PSI and will be in Chrome 159) Source : Barry Pollard, Bluesky
Google écrit désormais que le statut “Explorée, actuellement non indexée” ne signale pas forcément un problème
Google a réécrit, dans l'aide du rapport d'indexation de la Search Console, la ligne consacrée au statut "Explorée, actuellement non indexée". L'ancien texte indiquait que la page serait peut-être indexée plus tard, sans qu'il soit utile de la soumettre à nouveau. Le nouveau rappelle que Google n'indexe pas toutes les pages du web et que ce statut, courant, n'indique pas forcément un problème ; pour les pages importantes, il invite à chercher ce qui bloque l'indexation avec l'outil d'inspection d'URL et d'autres outils, et un formulaire permet de signaler un bug d'indexation qui toucherait tout le site. La qualité n'apparaît dans aucune des deux versions, alors que Google l'a déjà citée comme cause possible de ce statut.
Une 404 fait-elle du tort ? Non, répondent Gary Illyes et Cherry Prommawin dans une vidéo Google Search Central du 28 octobre : pas de pénalité ni d'effet sur les autres pages, et les 404 n'entament pas le budget d'exploration. Une redirection ne se justifie que s'il existe un vrai remplaçant, et Google traite une erreur 429 (trop de requêtes) comme une erreur serveur 5xx, en ralentissant l'exploration.
Et si seule la page d'accueil reste indexée ? À propos d'un site piraté l'an dernier puis nettoyé, John Mueller répond qu'il est impossible de se prononcer sans plus d'éléments, mais que le cas ressemble à un problème de qualité général, peut-être sans lien avec le piratage, sauf si celui-ci est resté en place de nombreux mois. Il ajoute qu'un piratage et une mise à jour principale qui tombent en même temps rendent le diagnostic difficile.
It's impossible to say without more information :-), but off-hand, this sounds like a general quality issue that might be unrelated to the hack (unless the hack was in place for a long time - ca many months). Times timing makes it hard to notice, eg when the hack & a core update happen together.
John Mueller (@johnmu.com) 2 novembre 2026
- Google Updates Crawled - Currently Not Indexed Details Source : Search Engine Roundtable
- Only Home Page Indexed? Might Be A Google Search Quality Issue Source : Search Engine Roundtable
- Should we be scared of a 404 status code? Source : Google Search Central
- It's impossible to say without more information Source : John Mueller, Bluesky
Bloquer dans le robots.txt le script d’une fenêtre de vérification d’âge fonctionnerait en général, selon Google
Sur Reddit, un internaute demande s'il peut empêcher Googlebot d'afficher, au rendu de la page, une fenêtre de vérification d'âge chargée depuis un domaine tiers. John Mueller répond que cela "fonctionnerait en général" et propose deux voies. Si le domaine tiers interdit l'exploration dans son robots.txt, Googlebot ne récupère pas ce contenu pendant le rendu et ne l'utilise pas, comme pour beaucoup de services publicitaires. Sinon, le site peut bloquer dans son propre robots.txt le fichier JavaScript dédié qui charge la fenêtre.
Quelle précaution prendre ? Ne pas bloquer un fichier JavaScript qui fait plusieurs choses à la fois, précise John Mueller, et s'assurer que la page se charge toujours quand la ressource n'est pas récupérée. En audit, contrôlez le rendu après le blocage avec le test en direct de l'outil d'inspection d'URL de la Search Console.
- Tech Question - Using robots to block a pop up Source : Reddit
- Google Says It's Okay To Block Some JavaScript Resources With Robots.txt Source : Search Engine Journal
- Google On How To Block Popups Using Robot.txt In Search Source : Search Engine Roundtable
Le moteur français ibou ouvre son API à 1 € HT les 1 000 unités
Développé par Babbar, le moteur de recherche français ibou quitte ibou.io pour ibou.com avec une nouvelle identité tournée vers le grand public, présentée le 26 octobre ; sa version conversationnelle reste promise "bientôt", sans date. Sa plateforme ibou Platform donne désormais accès à l'index par une API facturée 1,00 € HT les 1 000 unités, avec 100 unités offertes à l'inscription ; un appel réussi consomme de 1 à 5 unités selon le niveau de détail. Lors d'un test d'Abondance, l'API a renvoyé dix résultats en 406 millisecondes pour 3 unités.
À quoi sert-elle pour un site français ? À comparer à petit coût les positions ou les sources d'un index français avec celles de Google : 1 000 requêtes coûtent au plus 5 € HT.
- IBOU : le moteur français s'ouvre au grand public avant l'arrivée de sa version conversationnelle Source : Abondance
- API ibou : le moteur de recherche français ouvre son index pour 1 € les 1 000 unités Source : Abondance
Google Ads : l'annonce la moins bien notée convertit mieux dans 54,3 % des groupes étudiés
Adalysis, éditeur d'un outil Google Ads, a étudié plus de 5 900 comptes de ses clients. Dans les groupes d'annonces hors marque qui contiennent exactement deux annonces responsives sur le même ciblage, il a comparé les paires dont la note d'efficacité diffère (l'indicateur "Ad Strength" de Google, de "Poor" à "Excellent"). L'annonce la mieux notée reçoit plus d'impressions dans 63 % des groupes. Mais la moins bien notée obtient plus de conversions pour 1 000 impressions dans 54,3 % des groupes, et un coût par acquisition plus bas dans 51,5 % ; sur l'ensemble des groupes, le coût par acquisition des annonces les mieux notées est 11,8 % plus élevé.
Pourquoi ? Surtout à cause de l'épinglage. Dans la plupart des groupes comparés, une annonce est épinglée et l'autre non (épingler un titre, c'est le forcer à une position fixe), et l'épinglage fait en général baisser la note. Sur les annonces non épinglées, la note monte bien avec les résultats.
Une note "Average" ou "Poor" est-elle un défaut ? Pas en soi pour un annonceur B2B qui épingle ses titres : arbitrez vos tests sur le coût par acquisition.
Les chiffres viennent des seuls comptes clients d'Adalysis, qui décrit sa méthode, et aucune autre source ne les a encore recoupés.
- Google Favors High Ad Strength RSAs, But Lower-Rated Ads Convert Better Source : Search Engine Journal
LinkedIn réunit les performances de toutes vos publications dans un tableau exportable
Le 3 novembre, Sam Corrao Clanon, responsable produit créateurs chez LinkedIn, a présenté le "Post Performance Table", une seule vue pour toutes les publications d'un membre et leurs indicateurs, avec export des données. Le tableau réunit :
- les impressions et les membres touchés ;
- les vues et le temps de visionnage des vidéos ;
- les abonnés gagnés ;
- les réactions, les commentaires et les republications ;
- les envois en message privé et les enregistrements.
Le déploiement mondial commence cette semaine, sur ordinateur d'abord, puis sur mobile.
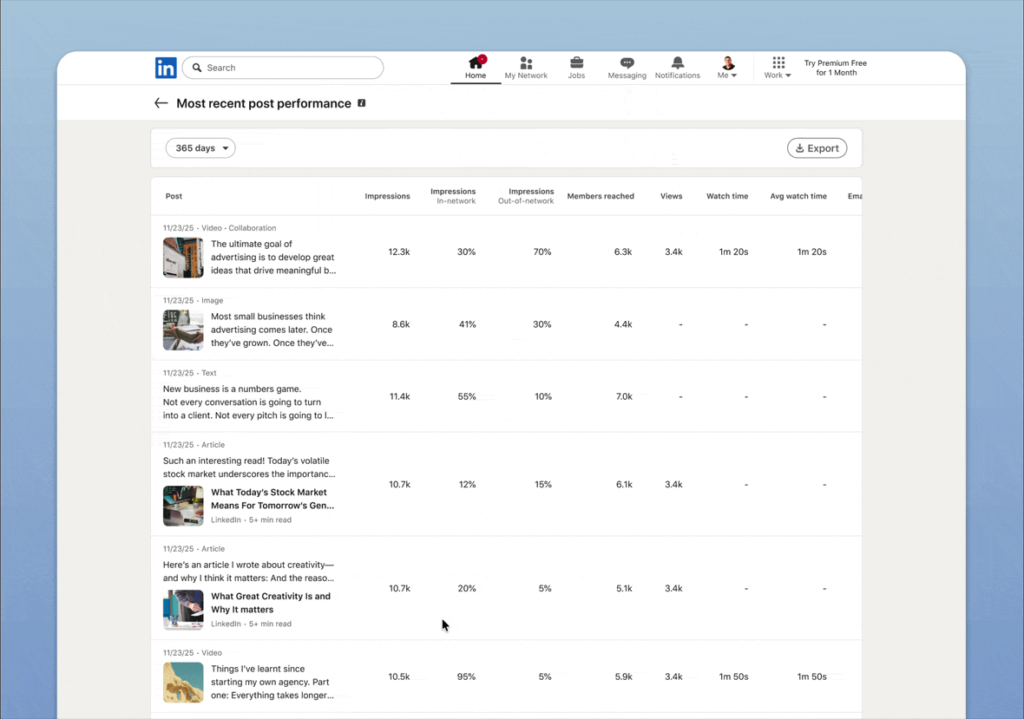
Que change ce tableau pour votre suivi LinkedIn ? Vous pouvez faire le point chaque mois sans relevé manuel, publication par publication. Et l'indicateur "abonnés gagnés" montre désormais qui s'est abonné après une publication donnée, avec son profil.
- LinkedIn lance un tableau qui centralise les performances de tous vos posts Source : Blog du Modérateur
- Understanding Your New Analytics on LinkedIn Source : LinkedIn
Les chiffres-clés à retenir
- 0,89 $ contre 2,45 $ : revenu respectif d'une visite issue d'une publicité ChatGPT et d'une annonce Google, sur 102 boutiques américaines au suivi financier complet (document de travail de Maximilian Kaiser et Christian Schulze, données Grips Intelligence).
- 0,36 % : part des visites envoyées par ChatGPT aux 118 671 sites équipés d'Ahrefs Web Analytics en octobre, contre 24,74 % pour Google (Ahrefs).
- 50 % à 83 % : part des citations de sites par une IA qui disparaissent le lendemain, des aperçus IA à Copilot ; 50 à 60 % pour les cinq outils une fois les réponses sans source écartées (chiffres publiés par Ahrefs).
- 17 % : part des marketeurs B2B qui citent la qualité parmi les apports de l'IA, contre 78 % pour la vitesse (Content Marketing Institute et MarketingProfs, 861 répondants, surtout nord-américains).
- 16,32 % : part de Bing sur ordinateur en France en octobre 2026, mesurée sur les visites envoyées au panel de sites de StatCounter, qui ne compte pas les recherches elles-mêmes (StatCounter, consulté le 5 novembre).
Retrouvez aussi mes dernières publications sur le LinkedIn de @Plume Numérique et de @Sandrine Lasserre
Les articles publiés cette semaine sur le blog de Plume Numérique
Voir tous les articles du blog
Retrouvez la revue de presse de la semaine précédente
Revue du digital – semaine du 22 octobre 2026
0 commentaire