Du 22 au 28 octobre 2026, Google a demandé aux éditeurs de pages partageables par lien de les garder hors de l'index par défaut, tandis que deux failles critiques dans PHP sont venues ébranler la sécurité des serveurs WordPress. Côté IA, 88 % des 400 mots-clés commerciaux suivis par Semrush sur ordinateur aux États-Unis déclenchent désormais un aperçu IA, alors que sur 100 sites passés au crible par Marie Haynes, ChatGPT n'apporte que l'équivalent de 0,62 % des visites venues de Google organique.
Cette semaine, trois chiffres omniprésents dans l'actualité méritent un sérieux rappel à l'ordre. Les fameux "plus de 80 % d'aperçus IA" agrègent en réalité un panel resserré de 400 mots-clés commerciaux et des recherches de marque. Les 84 % de faux robots GPTBot correspondent à une médiane observée par site, mais s'écroulent à 2 % dès que l'on compte l'ensemble du trafic. Enfin, lorsqu'une marque est citée dans 11,86 % des réponses IA, 29 de ses 35 citations peuvent provenir d'un seul et unique moteur. Dans le même temps, Semrush alerte sur de faux résultats renvoyés par Google à ses outils de mesure, et une équipe de chercheurs de Google détaille le filtre qui évince de Discover les articles jugés en fin de vie.
- Pages partageables : Google demande de laisser par défaut hors de la recherche les contenus conçus pour être diffusés par simple lien.
- PHP2Shell : deux failles critiques permettent d'exécuter du code à distance sur le serveur sans compte ; seule la mise à jour de PHP neutralise la menace.
- Aperçus IA : 88 % des 400 mots-clés commerciaux suivis par Semrush sur ordinateur aux États-Unis affichent un aperçu IA, contre 45,75 % en septembre 2025.
- Trafic ChatGPT : sur 100 sites, ChatGPT ne génère que l'équivalent de 0,62 % des sessions apportées par Google organique.
- Robots usurpateurs : sur un site de presse typique, 84 % des requêtes qui se présentent comme GPTBot ne viennent pas d'OpenAI.
- Résultats faussés : Semrush documente les résultats faussés que Google renvoie à certaines de ses requêtes automatisées.
- Visibilité IA : une marque citée dans 35 réponses sur 295 l'est 29 fois dans Google AI Mode, pour un zéro pointé dans ChatGPT.
- Signaux de citation : sur 96 418 URL examinées par SISTRIX, le fichier llms.txt n'apporte aucun avantage de citation.
- YouTube : les aperçus IA de Google citent YouTube dans 36,5 % de leurs réponses sur les logiciels B2B, contre à peine 2,1 % pour ChatGPT.
- Achats délégués : dans un panel de consommateurs américains, 0,8 % ont confié à un agent IA la finalisation de l'achat d'un logiciel ou d'un service B2B.
- Médias : le groupe Daily Mail mène 12 à 15 tests de présence dans les réponses des IA pour des marques, prélude à une offre dédiée.
- CRM : deux nouvelles approches proposent de chercher les mots-clés dans les motifs de perte commerciale et les situations décrites par les clients.
- Discover : un filtre écarte un article dès que Google estime qu'il a déjà reçu 90 % de son trafic.
Bonne lecture !
Table des matières
Google demande de tenir hors de la recherche les pages créées pour être partagées par lien
Le 26 octobre 2026, Google a enrichi sa page d'aide sur le spam généré par les utilisateurs d'une section intitulée "Only index content meant for Search". Il y vise les services qui laissent créer des pages partageables, des contenus générés ou des outils interactifs. Le mot d'ordre pour ces éditeurs : s'interroger sur la vocation de chaque page. A-t-elle été pensée pour être trouvée dans les moteurs, ou seulement pour être ouverte par les personnes qui disposent de son lien ? Dans ce dernier cas, Google demande d'appliquer par défaut la règle noindex, qui demande aux moteurs de ne pas afficher la page (balise meta robots ou en-tête X-Robots-Tag), ou bien de bloquer l'exploration dans le fichier robots.txt.
Qui est concerné ? Tout site qui génère des pages à partir d'une action de l'utilisateur : un résultat de simulateur ou de calculateur, un devis en ligne, un rapport sur mesure, un espace de travail collaboratif, une page de partage. Google écrit que ces fonctions peuvent, elles aussi, être détournées. Si vous éditez un logiciel B2B et proposez un outil gratuit en ligne qui génère des pages de résultat accessibles par URL, celles-ci entrent directement dans ce cadre.
Faut-il choisir le noindex ou le robots.txt ? Le noindex, posé sur une page que Google peut explorer, reste l'option la plus sûre. Google mentionne les deux méthodes, mais une URL simplement interdite dans le robots.txt peut se retrouver dans l'index si d'autres sites pointent vers elle. Or, pour prendre connaissance d'une consigne noindex, Google doit pouvoir lire la page : la bloquer dans le robots.txt l'empêche précisément de voir cette interdiction.
Que surveiller ensuite ? La même mise à jour invite à valider le site dans la Search Console, pour ne manquer aucune alerte d'action manuelle ou de sécurité, et à guetter les hausses soudaines de pages indexées, d'impressions ou de requêtes sans rapport avec l'activité. Ce type d'anomalie peut signaler qu'une fonction de partage sert à diffuser du spam sous votre propre nom de domaine.
La version française de la page d'aide n'intègre pas encore cette section (sa dernière mise à jour date du 18 décembre 2025) : reportez-vous à la version anglaise pour vérifier les détails.
- Prevent user-generated spam on your site and platform Source : Google Search Central (documentation)
- Google Search says you should block indexing of link-shared content Source : Search Engine Land
- Google Updates Spam Guide For Shared Pages, Generated Content & Apps Source : Search Engine Journal
- Google says pages meant only for sharing should stay out of search Source : Search Engine Watch
- Pages partagées et applications web : Google élargit ses consignes antispam Source : Position Zéro
- Google Updates User-Generated Spam Guidance To Specify Tools & More Source : Search Engine Roundtable
PHP2Shell : deux failles critiques de PHP exposent les sites WordPress
Deux failles nichées au cœur du moteur PHP, CVE-2026-109618 et CVE-2026-109619, permettent de déclencher l'exécution de code à distance sur un serveur, sans le moindre compte. Les correctifs officiels sont sortis le 21 octobre avec les versions 8.5.12, 8.4.27, 8.3.36 et 8.2.35. PHP 8.1 et les versions antérieures ne reçoivent aucun correctif, puisque le projet ne les maintient plus. Le CERT-FR a précisé dans sa mise à jour du 26 octobre qu'il constate des tentatives d'exploitation visant des déploiements spécifiques de PHP. De leur côté, les serveurs leurres d'Amazon avaient enregistré une première tentative dès le 17 octobre, bien avant toute annonce publique.
Mettre à jour WordPress suffit-il ? Absolument pas. Mettre à jour le CMS ou ses extensions ne comble rien, puisque la faille se situe dans PHP, sous le CMS. Le pare-feu applicatif de Cloudflare, activé le 21 octobre pour les clients qui y ont souscrit, fait gagner du temps en attendant la mise à jour. La menace concerne WordPress au même titre que Drupal, Joomla ou Magento, tous bâtis sur PHP.
Quelle version faut-il viser ? Appliquez la version corrigée de votre branche, au minimum :
- PHP 8.2 : 8.2.35 ;
- PHP 8.3 : 8.3.36 ;
- PHP 8.4 : 8.4.27 ;
- PHP 8.5 : 8.5.12.
Un serveur en 8.3.20, bien que son numéro paraisse supérieur à 8.2.35, laisse la porte grande ouverte. La version active se vérifie dans WordPress (Outils, Santé du site), ou auprès de votre hébergeur, qui peut vous la confirmer par écrit. En PHP 8.1 ou plus ancien, la seule issue est de passer à une version maintenue, après avoir vérifié que le thème, les extensions et les applications la supportent, et en testant d'abord le changement sur une copie du site quand c'est possible.
Que faire si le site doit être coupé pour la mise à jour ? Renvoyer un code 503, qui signale une indisponibilité temporaire, plutôt qu'une erreur 404 ou une page de maintenance qui répond 200 : Google Search Central l'a rappelé le 21 octobre, le jour des correctifs. Comme PHP est coupé, ce code se sert en amont, par une règle du CDN, le réseau qui distribue les pages du site, ou par un serveur temporaire vers lequel pointe le DNS. John Mueller, de Google, a d'ailleurs rappelé que le 503 n'a pas besoin de passer par PHP. Google conseille de ne pas le servir plus d'un ou deux jours, au risque de voir des URL sortir de l'index.
Le bulletin d'alerte du CERT-FR a connu quatre mises à jour depuis sa première version, la dernière le 27 octobre. Une troisième faille, CVE-2026-115560, annoncée le 23 octobre, s'avère plus difficile à exploiter.
- Failles critiques dans PHP : quelles versions mettre à jour et comment protéger ses serveurs Source : Blog du Modérateur
- PHP2Shell: What it is and why you don't need to panic Source : Hostinger
- Google Explains 503s, Robots.txt Limits & Bracket URLs – SEO Pulse Source : Search Engine Journal
- Multiples vulnérabilités dans PHP (CERTFR-2026-ALE-014) Source : CERT-FR
88 % des 400 mots-clés commerciaux suivis par Semrush déclenchent un aperçu IA
Semrush suit 400 mots-clés commerciaux sur ordinateur aux États-Unis, répartis entre la banque, l'e-commerce et le logiciel, autour de cinq formulations : alternatives, "meilleur X pour Y", prix, avis et marque contre marque. Sur cette sélection, la part des mots-clés qui déclenchent un aperçu IA a grimpé en flèche, de 45,75 % en septembre 2025 à 88 % en août 2026, et atteint 97 % une fois pondérée par le volume de recherche estimé. De son côté, SE Ranking relève un aperçu IA dans 82,5 % de ses relevés américains et 40,4 % de ses relevés allemands, sur 1 000 mots-clés de marque par pays relevés trois fois sur ordinateur en octobre.
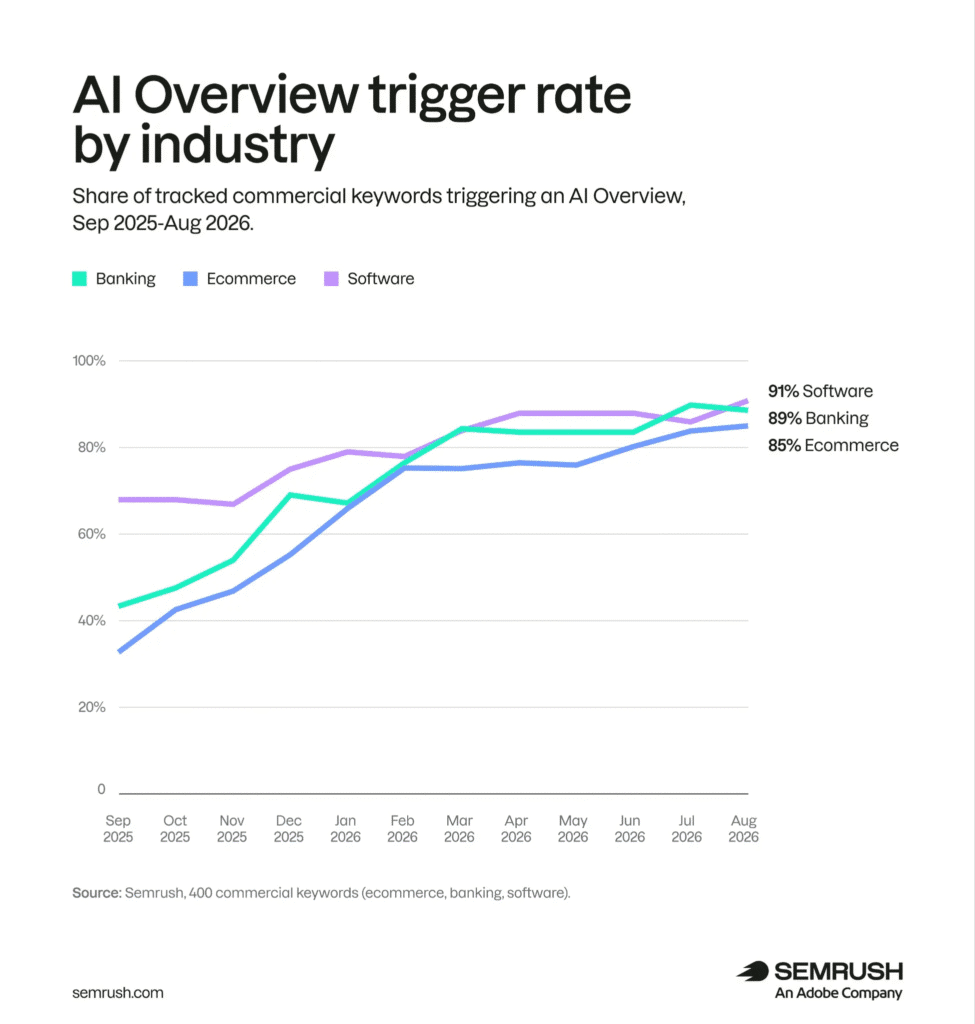
D'où vient le "plus de 80 % des recherches Google" qui circule ? D'un titre qui associe les données de Semrush, les relevés de SE Ranking, le graphique du Semrush Sensor, l'outil de suivi de Semrush, et un propos rapporté de seoClarity. Or aucune de ces sources ne mesure "les recherches Google" : Semrush s'appuie sur une liste fermée de mots-clés commerciaux, SE Ranking sur des recherches de marque. Ces travaux confirment néanmoins que sur ces requêtes commerciales, l'aperçu IA s'est imposé comme la norme aux États-Unis sur ordinateur. Aucun ne dit ce qu'il en est sur mobile ou en France, et l'écart entre les États-Unis et l'Allemagne incite à ne pas généraliser trop vite.
Quelles pages de votre marque l'aperçu IA cite-t-il ? La page d'accueil reste la plus citée, mais elle pèse deux fois moins dans les citations que dans les dix premiers résultats. Selon SE Ranking, les pages d'accueil font 71,1 % des URL de marque du top 10 organique, et seulement 36,8 % des citations de la marque dans les aperçus IA. Viennent ensuite les pages produit, service et catégorie (22,9 %), puis les pages "à propos" (11,7 %). Aux États-Unis, 62,2 % des pages de marque citées n'apparaissent pas dans le top 10 de la même recherche, alors que 98,3 % des citations viennent d'un domaine déjà présent dans ce top 10. Votre page produit ou "à propos" peut donc être citée sans être classée en première page, pourvu que votre site, lui, le soit.
L'étude de Semrush est parue le 21 octobre ; elle ne mesure pas l'effet de ces aperçus sur les clics ni sur les conversions.
- Google AI Overviews nearly double for commercial keywords: Study Source : Search Engine Land, propriété de Semrush
- AI Overviews Appear on 82.5% of US Brand Searches. Here Are the Brand Pages They Cite the Most Source : SE Ranking
- Over 80% Of Google Searches Have AI Overviews & Growing Source : Search Engine Roundtable
- Les AI Overviews dépassent 80 % sur plusieurs échantillons de requêtes Source : Position Zéro
ChatGPT apporte l’équivalent de 0,62 % des visites de Google organique
En épluchant douze mois de données GA4 sur 100 sites, soit plus de 145 millions de sessions, la consultante SEO Marie Haynes constate que les sessions venues de ChatGPT ne représentent que l'équivalent de 0,62 % du volume de Google organique. Ce ratio monte timidement à 0,73 % en ajoutant tous les assistants IA. Sur les 55 sites qui suivent des conversions, le taux de conversion de ChatGPT se révèle plus flatteur (13,8 % contre 3,02 %), mais Google organique réalise 96,5 % des conversions des canaux comparés, 27 fois plus que tous les assistants réunis. Son constat est sans appel : le GEO, l'optimisation pour les réponses des IA, est une distraction.
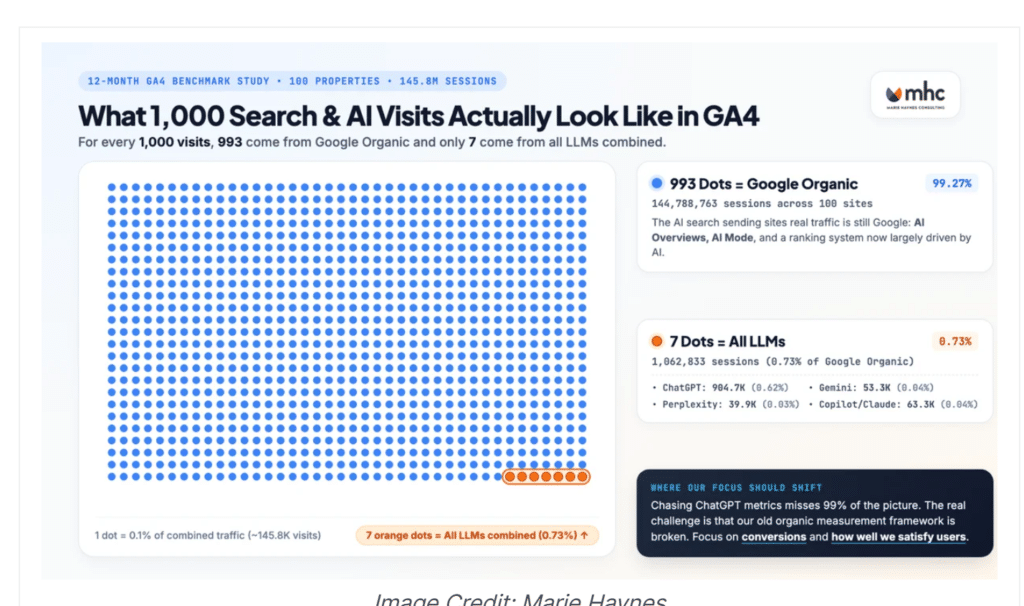
Pourquoi tout le monde n'est-il pas d'accord ? Parce que Mike King, fondateur de l'agence iPullRank, valide les chiffres mais rejette la conclusion : selon lui, ces études jugent un canal de marque avec un étalon de trafic. Une partie des visites venues des IA arrive en accès direct, les clics des surfaces IA de Google sont le plus souvent comptés dans "Google organique", et un acheteur peut très bien composer sa liste dans un assistant avant de chercher la marque sur Google. À ce jour, personne n'a publié de mesure qui tranche entre ces deux lectures.
Le trafic IA convertit-il mieux ? Pas partout. Dans le baromètre de l'agence The SEO Works, publié début septembre et cité par les deux camps, le trafic IA convertit moins bien que l'organique sur 23 des 63 sites étudiés sur ce point, et l'organique apporte environ 30 fois plus de conversions que les assistants IA.
Que faire avant de juger un travail de visibilité IA ? Commencez par vérifier vos mesures : 45 des 100 sites analysés par Marie Haynes ne suivaient pas leurs conversions dans GA4. Ajoutez ensuite "un assistant IA" aux réponses possibles du champ "Comment nous avez-vous connus ?" de vos formulaires de contact et de démonstration. Les recommandations des IA qui arrivent ensuite par une recherche de marque deviennent alors visibles, au moins en partie.
Et en France ? Le recul de l'organique y est plus marqué qu'aux États-Unis, sans que l'on puisse tout imputer à l'IA. Kevin Indig, consultant en croissance, a passé en revue les estimations Similarweb de 7 730 sites français : leurs visites organiques ont reculé de 24,4 % entre août 2024 et août 2026, contre 13,2 % aux États-Unis. La baisse est très concentrée : 1 % des domaines français porte à lui seul 48,5 % des visites perdues. Les éditeurs de presse perdent 42,5 %, et la baisse reste de 22,5 % en France hors éditeurs. Sur 1 725 sites présents dans les deux pays, les visites organiques quotidiennes ont reculé de 5,1 % en France et de 3,6 % aux États-Unis entre juin et août 2026. Selon Kevin Indig, l'effet de la publicité, qui capte elle aussi des clics autrefois dévolus à l'organique, est nettement sous-estimé et attribué à tort aux aperçus IA ; il rappelle aussi le poids des mises à jour de Google.
- GEO Is A Distraction: Here's Where The Real Opportunity Is Source : Search Engine Journal
- AI search is a branding channel, not a distraction Source : Search Engine Land
- Is AI Visibility a Marketing BoonDoggle? Source : SparkToro
- Organic traffic is down, but it's not all AI Source : Growth Memo
Sur un site de presse typique, 84 % des requêtes qui se disent GPTBot sont fausses
Dans un rapport publié fin septembre, Centinel, qui vend une solution de protection contre les robots, a vérifié l'origine des requêtes reçues par les sites de presse qu'il protège, de fin juin au 21 septembre 2026. Sur le site typique (la médiane des sites qui reçoivent un nombre significatif de requêtes à ce nom), le constat est frappant : 84 % des requêtes qui se présentent comme GPTBot ne viennent pas d'OpenAI. Le taux atteint 99 % pour Perplexity-User, et une requête sur sept pour Googlebot.
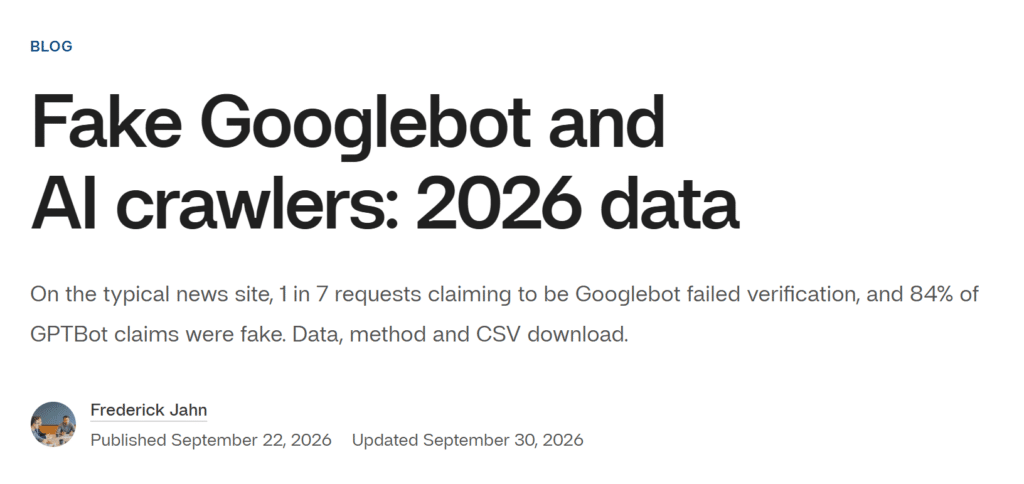
Pourquoi ce chiffre ne vaut-il pas pour tout le trafic ? Parce qu'en additionnant toutes les requêtes, les faux GPTBot ne pèsent plus que 2 % du trafic de ce robot, et les faux Googlebot 6 %. Le vrai GPTBot passe surtout sur quelques gros sites et rarement sur le site typique, où les imitateurs se taillent alors la part du lion. Pour Perplexity-User, en revanche, la part d'imposteurs reste écrasante en cumulé, à 96 %.
Que change ce constat pour vos journaux serveur ? Une ligne "GPTBot" ou "Googlebot" dans vos journaux ne prouve en rien que le vrai robot est passé. Avant de conclure qu'OpenAI explore vos pages, ou de bloquer un robot, vérifiez l'origine des requêtes au niveau du serveur ou du CDN. Centinel juge une requête fausse quand les plages d'adresses IP publiées par l'opérateur du robot, ou une vérification DNS, contredisent le nom qu'elle annonce. Le robots.txt n'est qu'une demande que seuls les robots déclarés respectent : People Inc., éditeur de presse américain, bloque désormais les robots par défaut au niveau du CDN.
Que règle le robots.txt ? L'exploration, pas l'usage des contenus. Gary Illyes, de Google, rappelle que l'analyseur de Google ne lit que quatre règles (user-agent, allow, disallow, sitemap) et écarte sans message toute autre ligne. Une interdiction d'usage par l'IA rédigée en langage naturel n'a donc aucun effet chez Google. Pour refuser l'usage de vos contenus par les modèles Gemini sans sortir de la recherche, Google propose le jeton Google-Extended.
Gardons à l'esprit que ces chiffres émanent d'un éditeur qui vend la protection contre ces robots, sur la base de ses seuls clients.
- Media Briefing: The transatlantic push to rein in stealth bots is gathering pace Source : Digiday
- Robots.txt et crawlers IA : Google rappelle quelques règles fondamentales Source : Abondance
- Google Explains 503s, Robots.txt Limits & Bracket URLs – SEO Pulse Source : Search Engine Journal
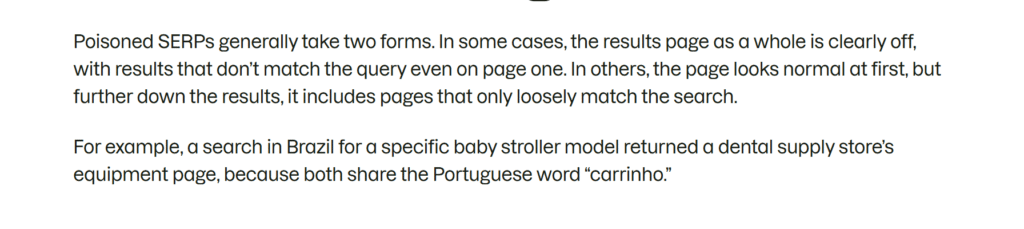
Semrush décrit les faux résultats que Google renvoie à ses outils de suivi
Le 27 octobre, Semrush a publié une mise au point sur les pages de résultats "empoisonnées" : Google renvoie à certaines requêtes automatisées des pages qui ne correspondent pas à ce que voit un internaute. Elles sont soit totalement hors sujet, soit cohérentes en tête et dégradées plus bas. Semrush prend l'exemple d'une recherche de poussette au Brésil qui renvoie vers un fournisseur de matériel dentaire, le mot "carrinho" étant partagé par les deux univers. L'éditeur indique écarter les résultats invalides, avoir changé de sources de données et recollecter les résultats douteux. Parallèlement, les classements ont fortement bougé le samedi 24 et le mardi 27 octobre, sans mise à jour annoncée par Google.
Peut-on se fier à ses positions cette semaine ? Pas sans les recouper. Les secousses du 24 et du 27 octobre sont elles-mêmes mesurées par des outils dont la collecte reste perturbée. En cas de variation inattendue, Semrush recommande de comparer à la Search Console. Jugez donc une hausse ou une baisse vue dans un outil tiers sur les clics et les conversions de la Search Console et de GA4, et indiquez sur chaque position de vos rapports clients l'outil qui l'a mesurée.
Les chiffres de Nozzle publiés début octobre tiennent-ils encore ? Ils ne jouent plus dans la même catégorie. Les chiffres de Nozzle relayés cette semaine portent sur les pages 1 et 2 des résultats : depuis le 13 septembre, Nozzle a jugé faussées 22,6 % des pages de résultats vérifiées sur ces deux pages, contre 0,28 % pendant sa période de référence. Ils ne se comparent donc pas aux 8 % puis aux 8,4 % que nous citions dans notre édition du 8 octobre et dans celle du 15 octobre.
Mon rapport d'indexation n'a pas bougé depuis des jours, c'est grave ? Pas en soi. Sur Reddit, un propriétaire de site s'inquiétait de voir son rapport "Indexation des pages" de la Search Console figé depuis le 16 octobre. John Mueller, de Google, lui a répondu le 24 octobre que son site était récent et ses chiffres stables, que "l'indexation ne change pas vite" et que "quand elle change, on le voit d'abord dans les rapports de performances". Il ajoute que Google ne commente pas la fraîcheur de chaque rapport : "c'est pour ça que nous y mettons des dates". Pour vérifier que Google voit vos nouvelles pages, isolez ces URL dans le rapport de performances et regardez si elles commencent à recevoir des impressions.
- Poisoned SERPs: An update on Google ranking data in Semrush Source : Semrush
- Semrush confirms 'poisoned' Google results are impacting SEO tools Source : Search Engine Land
- Unconfirmed Google Search Ranking Update: Volatility & Chatter Spike Source : Search Engine Roundtable
- Google Search Ranking Volatility Gets Heated October 24th Source : Search Engine Roundtable
- GSC Page Indexing report hasn't updated since Oct 16th - is the data pipeline stalled for anyone else? Source : Reddit, r/TechSEO
- Google Downplays The Importance Of Fresh Index Reporting Source : Search Engine Roundtable
- Google Responds To Concern Over Search Console Indexing Reports Source : Search Engine Journal
ChatGPT n’a cité la marque dans aucune de ses 75 réponses, Google AI Mode dans 29 sur 72
Bertrand Morel, qui dirige Edikka, a publié les résultats de l'étude MIA-FR, que son entreprise a menée le 26 août pour mesurer sa propre visibilité : 25 questions en français qui ne nomment pas la marque, posées trois fois chacune à ChatGPT, Claude, Perplexity et Google AI Mode. Sur 295 réponses valides, 35 citent une page d'Edikka comme source, soit 11,86 %. Un résultat très éclaté : 29 réponses sur 72 dans Google AI Mode, 5 sur 74 dans Perplexity, 1 sur 74 dans Claude et aucune sur 75 dans ChatGPT.
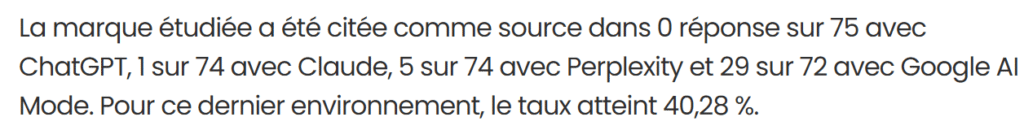
Que cache un score de visibilité IA unique ? Un chiffre consolidé peut tromper son monde : une marque peut briller dans une IA et rester quasi invisible dans les autres. Ici, la moyenne de 11,86 % ne correspond à la réalité d'aucun des quatre moteurs. Bertrand Morel distingue aussi la citation (une page de la marque donnée comme source) de la mention (le nom de la marque dans la réponse) : une marque peut être nommée sans que son site soit cité, et inversement. Additionner les deux dans une note globale, ou additionner les moteurs, mélange des mesures différentes.
Une IA répond-elle toujours la même chose ? Loin de là, ce qui impose de poser chaque question plusieurs fois. Le 17 septembre, un consultant de l'agence Seer a lancé deux fois le même prompt dans ChatGPT, à huit minutes d'intervalle : les recherches lancées en coulisses par ChatGPT n'avaient aucune formulation exacte en commun. Un relevé fait une seule fois n'a donc que la valeur d'un instantané. Tom Capper, de l'outil STAT, traite cette variabilité comme un problème d'échantillonnage, comparable aux résultats qui changent selon le lieu et l'appareil : un petit panier de questions donne une image instable, et il faut couvrir assez largement les situations des acheteurs pour voir des tendances.
Que demander à un prestataire ou à un outil de suivi ? Le détail moteur par moteur, le nombre de questions et de répétitions, la part de citations et celle de mentions, et la façon dont les réponses sont collectées. Tom Capper ajoute que STAT relève les réponses dans l'interface web, parce que celles obtenues par l'API, l'accès automatisé, peuvent différer de ce que voit l'utilisateur.
Notons que l'étude porte sur une seule marque, un seul jour de collecte et 25 questions, et qu'elle est publiée par la marque étudiée elle-même, qui a déposé ses données en accès libre le 26 août.
- ChatGPT, Claude, Perplexity, Google AI Mode : pourquoi leurs citations ne se comparent pas Source : Journal du Net, tribune de Bertrand Morel, dirigeant d'Edikka
- Same Prompt, Different Data Structure: ChatGPT's Search Data Keeps Changing Source : Seer Interactive
- Tactical Solutions For The Biggest AI Search Measurement Challenges Source : Search Engine Journal
Sur 96 418 URL analysées par SISTRIX, le fichier llms.txt ne montre aucun avantage de citation
SISTRIX a comparé, sur des sites d'Allemagne, d'Autriche et de Suisse, des pages citées par ChatGPT, Google AI Mode ou les aperçus IA à des pages non citées du même domaine, neutralisant ainsi le poids de la marque. Les pages citées se distinguent plus souvent par :
- une table des matières ;
- des données structurées Article et FAQPage ;
- des intertitres H2 rédigés sous forme de questions ;
- des tableaux et des listes ;
- un encadré auteur ;
- une date de mise à jour visible ;
- des sources citées.
En revanche, le fichier llms.txt, les données structurées Breadcrumb et HowTo et la lisibilité mesurée par le score Flesch ne montrent aucun effet.
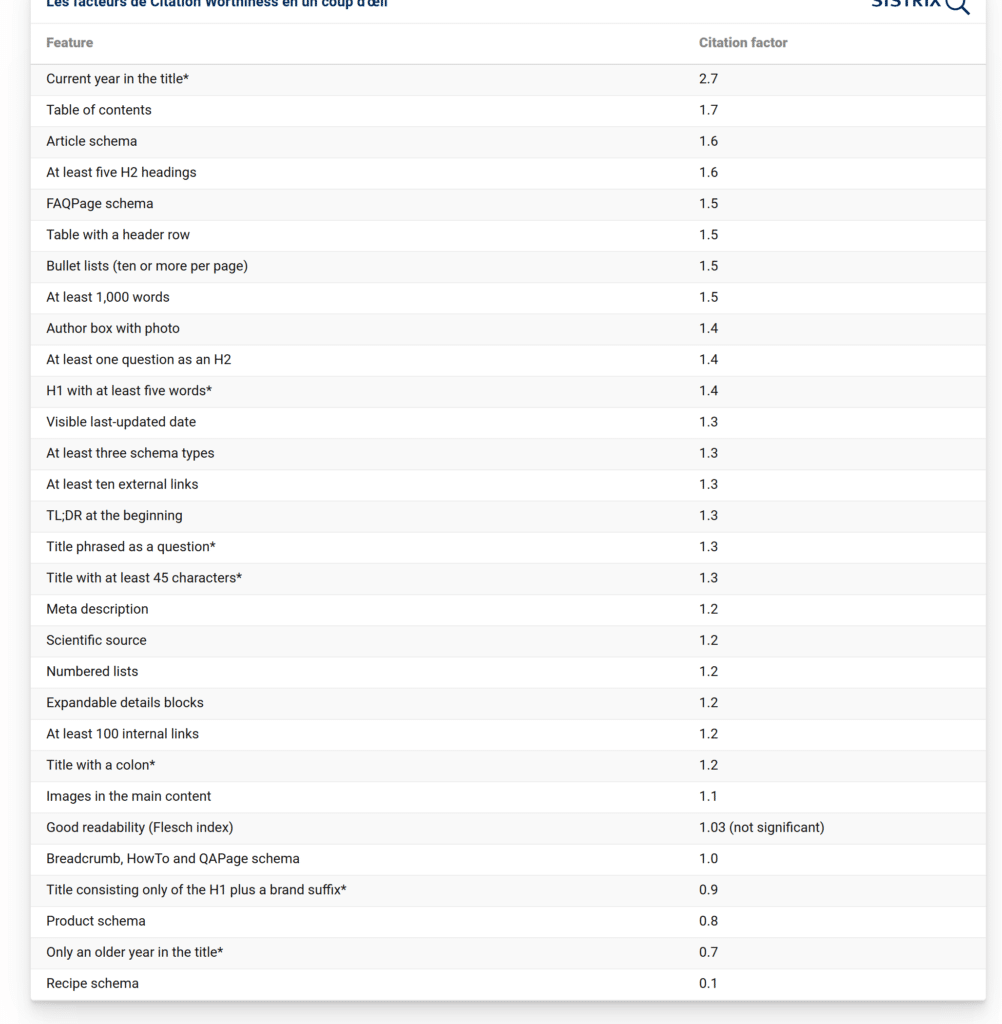
Que dit l'étude du fichier llms.txt ? Qu'il n'apporte "aucun avantage mesurable". Les domaines qui en ont un fournissent 11,7 % des URL citées, alors qu'ils représentent 14,0 % de l'ensemble des domaines étudiés. SISTRIX précise que cette comparaison se fait entre domaines, et qu'elle ne permet pas d'affirmer que le fichier pénalise les sites concernés.
Les éléments relevés par SISTRIX font-ils citer une page ? Ces chiffres décrivent des corrélations, comme SISTRIX le précise lui-même dans ses limites. Une autre recherche parue cette semaine met en lumière ce que les systèmes d'IA perdent en lisant une page. Tessera, papier de recherche déposé sur arXiv le 27 octobre et mené sur Wikipédia en anglais, établit que l'extraction de texte des systèmes de recherche par IA perd 44 % des légendes de tableaux, 40 % des légendes de figures et 16 % des cellules de tableau citées comme preuves, contre seulement 1 % des paragraphes.
Qu'en tirer pour une page qui vend ? Placez la réponse dès la première phrase de chaque section, et ne laissez jamais une donnée importante enfermée dans une légende ou un tableau : une phrase du texte doit dire ce que le tableau démontre. L'étude de TJ Robertson, menée sur 193 507 réponses de ChatGPT, de Google AI Mode et des aperçus IA pour les clients de son agence, associe elle aussi les citations à une réponse dès les premières lignes, à une date de mise à jour visible, aux prix et aux tableaux.
- Citation Worthiness : quelles pratiques GEO résistent à l'analyse de 96 418 URL Source : SISTRIX
- Tessera: Structure-Completed Evidence Units for Web Retrieval-Augmented Generation Source : arXiv
- Our 2026 AI Citation Study of 193,507 ChatGPT, Google AI Mode and AI Overview Answers Source : TJ Digital
Les aperçus IA de Google citent YouTube dans 36,5 % de leurs réponses sur les logiciels B2B, ChatGPT dans 2,1 %
Durant 13 semaines, l'agence Foundation a étudié, avec les données de Writesonic, 182 631 réponses à 5 000 questions d'achat de logiciels B2B aux États-Unis. YouTube est cité dans 36,5 % des réponses des aperçus IA, 35,6 % de celles de Google AI Mode et seulement 2,1 % de celles de ChatGPT. Sur les 83 835 citations vers YouTube, 98,2 % viennent des deux surfaces de Google.
Quelles vidéos sont citées ? Principalement des formats de 5 à 15 minutes dont le titre reprend la question d'achat ("meilleur", "vs", l'année), et qui sont découpés en chapitres : 56 % des vidéos les plus citées affichent au moins trois horodatages dans leur description, contre 33 % de celles citées une seule fois. La taille de la chaîne ne pèse presque pas. Les auteurs conseillent aussi d'énoncer son verdict sans attendre, parce que Google cite un moment précis de la vidéo : environ la moitié de ses citations de vidéos pointent vers un horodatage, et environ 71 % de celles-ci vers les cinq premières minutes. Fournir ses propres sous-titres n'apporte en revanche aucun avantage mesuré : mieux vaut corriger les erreurs des sous-titres automatiques, surtout sur les noms de produits et les termes techniques.
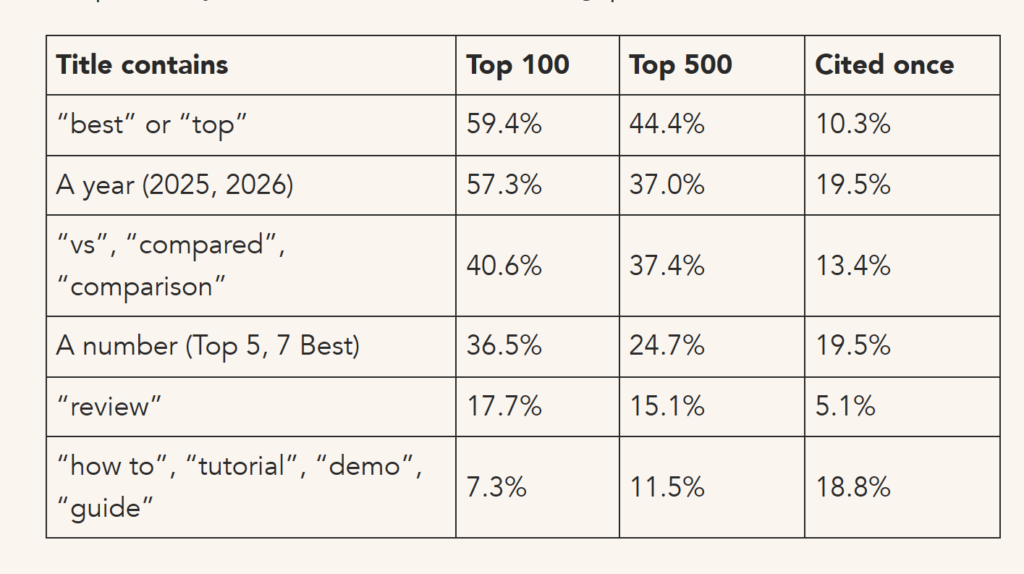
Un second relevé confirme-t-il les niveaux de Foundation ? Il confirme la tendance, avec des niveaux plus modérés. L'étude de TJ Robertson, menée sur les clients de son agence, trouve YouTube dans 23 % des réponses des aperçus IA, 9 % de celles de Google AI Mode et presque aucune de ChatGPT. Si vous vendez un logiciel B2B, la vidéo sert donc avant tout les réponses IA de Google, et le geste le plus direct est de transposer vos comparatifs écrits en vidéos titrées comme les questions des acheteurs, avec des chapitres nommés comme des questions.
Les auteurs de l'étude Foundation rappellent eux-mêmes leurs limites : ce sont des corrélations, la comparaison oppose les vidéos citées souvent à celles citées une seule fois, et l'étude ne mesure ni les clics ni les ventes qui suivent.
- YouTube AI Citations: What 17,780 Cited Videos Have in Common Source : Foundation
- Google's AI Cites YouTube 17x More Than ChatGPT. Here's What Gets Videos Cited. Source : Foundation
- Our 2026 AI Citation Study of 193,507 ChatGPT, Google AI Mode and AI Overview Answers Source : TJ Digital
Logiciel B2B : 0,8 % d'un panel de consommateurs américains a laissé un agent IA finaliser l'achat
L'agence First Page Sage a combiné un panel de 4 936 consommateurs en ligne américains, les commandes de 43 marques et 18 400 prompts testés, du 13 juillet au 16 octobre 2026. Pour les logiciels et services B2B, 49,3 % des membres du panel ont utilisé l'IA pour se renseigner, mais seulement 0,8 % ont laissé un agent finaliser la commande. De son côté, l'éditeur Omnibound n'a trouvé aucune mesure indépendante de la part des achats B2B que traitent aujourd'hui des agents.
L'IA est-elle un lieu d'achat pour le B2B ? Pas pour le moment : elle sert avant tout à chercher et à comparer. Selon la lecture d'Omnibound, les fonctions qui font agir un assistant (paiement, réservation) visent presque toutes le commerce de détail et la réservation locale. Le panel de First Page Sage étant formé de consommateurs, son chiffre se lit comme l'esquisse d'une tendance.
Qu'est-ce qui empêche un agent de comparer une offre ? Une page qu'il lit mal. D'après la documentation d'un éditeur d'agents citée par Omnibound, un agent lit une page de trois façons : par capture d'écran, par son code HTML et par son arbre d'accessibilité, la carte simplifiée que le navigateur construit à partir de la page. Omnibound en déduit les frictions prévisibles sur un site B2B : prix figés dans une image, informations de sécurité enfermées dans un PDF, champs de formulaire sans libellé, menus qui ne s'ouvrent qu'au survol. Omnibound précise qu'il s'agit de sa lecture de cette documentation, qu'il n'a pas mesurée.
Faut-il publier une version des pages réservée aux agents ? Certainement pas. Chris Green, consultant SEO, rappelle qu'une information servie aux machines et absente de la page que voient les clients reproduit la logique du cloaking, qui consiste à montrer aux robots autre chose qu'aux visiteurs et que les moteurs ont fini par sanctionner comme du spam. Écrivez plutôt en texte, sur vos pages publiques, les faits de votre offre (prix ou fourchette, délais, intégrations, certifications), identiques d'une page à l'autre.
- L'IA accompagne les recherches d'achat, mais les commandes déléguées restent minoritaires Source : Position Zéro
- Agentic Commerce Statistics: October 2026 Source : First Page Sage
- From Answers to Actions: What AI Search Means for B2B Source : Omnibound
- Agentic Buying in B2B: Preparing for the Machine Customer Source : Omnibound
- Agents Are Users: Designing B2B Sites for AI Agents Source : Omnibound
- Why We Should Fear The Shadow Web We're Building For AI Source : Search Engine Journal
Le Daily Mail mène 12 à 15 tests de visibilité dans les réponses IA pour des marques
Le groupe du Daily Mail mène 12 à 15 tests pour des marques, aux États-Unis, au Royaume-Uni et en Australie, afin de vérifier si leurs contenus publiés chez lui sont repris dans les réponses des IA. Il prévoit d'en faire une offre commerciale officielle au début de l'année prochaine. Déjà, des plateformes d'articles sponsorisés présentent leurs espaces comme des sources citées par les IA, et Muck Rack, éditeur d'outils de relations presse, met en avant le suivi de la visibilité IA dans son offre.
Acheter de la présence dans un média, est-ce acheter de la visibilité IA ? Uniquement si ce média est réellement cité par les IA sur les questions de vos acheteurs. Getfluence, qui commercialise ces placements, conseille lui-même de choisir des médias qui se classent sur Google et sont déjà cités par les IA. Sans cette vérification, l'opération se résume à un achat d'espace classique, à juger comme tel dans votre budget.
Une mention payée dans une réponse IA est-elle un risque ? Oui, selon Page One Power, agence spécialisée dans les liens : ces "mentions IA" se vendent et se tarifent comme des liens payés, et tombent sous les mêmes règles anti-spam de Google. Son relevé porte sur dix vendeurs, dont trois adossent leur prix au Domain Rating ou au Domain Authority du site, deux scores d'autorité calculés par des outils SEO. Google traite l'échange d'argent contre un lien comme une infraction, sauf si le lien porte l'attribut sponsored ou nofollow, et trois des dix vendeurs relevés promettent explicitement des liens qui transmettent leur popularité (dofollow).
- The Daily Mail tests GEO with brands ahead of AI visibility product Source : Digiday
- Paid Mentions Are Just Paid Links Wearing a GEO Costume Source : Page One Power
- SEO ou GEO ? Pourquoi un même article peut ranker sur Google et être cité par l'IA Source : Abondance
- Muck Rack Named as a Leader in the 2026 First-Ever Gartner® Magic Quadrant™ for PR and Media Monitoring Tools Source : Muck Rack
Dejan Predic propose de chercher vos mots-clés dans les motifs de perte du CRM
Deux approches parues cette semaine partent de la parole des clients pour choisir les sujets. La première, de Dejan Predic, propose d'exporter du CRM les motifs de perte et les objections notés par les commerciaux, puis de les recouper avec les données des outils de recherche. La seconde, de Rich Sanger, écrite pour la recherche locale, complète la liste de mots-clés par les situations, les contraintes et les critères que décrivent les clients.
Qu'apporte le CRM qu'un outil de mots-clés ne donne pas ? Les vraies préoccupations d'acheteurs qualifiés. Une requête qui ne compte que quelques dizaines de recherches par mois peut venir d'un acheteur prêt à un achat de grande valeur, ce que les volumes de recherche ne permettent pas de deviner : l'exemple de l'auteur est un cabinet médical.
Comment interroger ces clients ? Sur des faits, comme le déroulé de leur dernier achat, plutôt que sur leurs raisons, et après avoir écrit ses hypothèses, conseille la newsletter La Growth Semaine (n° 274). Les écarts entre le sondage et les entretiens font apparaître ce qui ne colle pas avec les hypothèses de départ.
- Your CRM might be your most underrated keyword research tool Source : Search Engine Land
- 6 steps to map local search intent beyond keyword data Source : Search Engine Land
- Le mirage de la User Research... - La GS #274 Source : La Growth Semaine
Google Discover écarte un article dès qu’il estime 90 % de son trafic déjà reçu
Une équipe de chercheurs de Google a levé le voile sur le filtre qui retire de Discover les articles jugés périmés, avant même leur classement, et qui y est en production depuis deux ans. Il combine deux modèles. Le premier repère l'article rendu caduc par un contenu plus récent sur le même sujet, comme un avant-match une fois le résultat connu. Le second estime la part du trafic de vie que l'article a déjà reçue, à partir de son texte, de ses images et de ses vidéos, et le retire quand elle atteint 90 %.
Que signifie "trafic de vie" ici ? Les clics venus de la recherche Google : les auteurs ont écarté les pages vues pour entraîner ce modèle. Un article écarté par ce filtre sort de la sélection, quel que soit l'engagement qu'il suscite encore.
Qui est concerné ? Au premier chef, les éditeurs qui vivent de Discover. Le modèle lit le contenu de l'article : une formule datée dans le titre ou la photo d'un événement terminé peut suffire à faire classer comme éphémère un guide qui reste utile des semaines. Si votre site B2B reçoit peu de trafic Discover, vous êtes peu concerné.
- Google Discover retire vos articles avant même de les classer : six réflexes pour les éditeurs. Source : Abondance, tribune de Sylvain Deaure, cofondateur de 1492.vision, qui en tire ses propres réflexes
Les chiffres-clés à retenir
- 88 % : part des 400 mots-clés commerciaux suivis par Semrush aux États-Unis, sur ordinateur, qui déclenchent un aperçu IA en août 2026, contre 45,75 % en septembre 2025 (Semrush).
- 40,4 % : part des relevés de recherches de marque avec aperçu IA en Allemagne, contre 82,5 % aux États-Unis (SE Ranking, 1 000 mots-clés par pays, trois relevés sur ordinateur en octobre).
- 0,62 % : trafic apporté par ChatGPT rapporté à celui de Google organique, sur 100 sites et douze mois de données GA4 (Marie Haynes).
- 45 sur 100 : sites de l'échantillon de Marie Haynes qui ne suivaient pas leurs conversions dans GA4.
- 2 % : part des fausses requêtes GPTBot dans le trafic cumulé de ce robot, contre 84 % sur un site de presse typique (Centinel, rapport de fin septembre, sur les sites de presse qu'il protège).
- 0 sur 75 : réponses de ChatGPT qui citent une page d'Edikka, la marque étudiée, contre 29 sur 72 dans Google AI Mode (étude MIA-FR, 25 questions posées trois fois).
- 36,5 % contre 2,1 % : part des réponses des aperçus IA et de ChatGPT qui citent YouTube, sur 5 000 questions d'achat de logiciels B2B (Foundation, données Writesonic).
- 8.3.36 : version minimale de PHP sur la branche 8.3 après les failles PHP2Shell (CERT-FR).
Retrouvez aussi mes dernières publications sur le LinkedIn de @Plume Numérique et de @Sandrine Lasserre
Les articles publiés cette semaine sur le blog de Plume Numérique
Voir tous les articles du blog
Retrouvez la revue de presse de la semaine précédente
Revue du digital – semaine du 15 octobre 2026
0 commentaire