Google a réécrit deux pages de sa documentation en une semaine : la relecture humaine des contenus IA devient "critique" jusque dans les balises title, et fabriquer un profil d'auteur est désormais qualifié de tromperie. Au même moment, les aperçus IA s'affichent sur 82,91 % des recherches de marque, et une étude sur 4 213 requêtes mesure que les marques sans aucun balisage sont recommandées autant que celles qui en empilent six types.
Google a écrit cette semaine ce qu'il attend, et les mesures publiées situent l'effort utile ailleurs que là où le marché investit. Deux pages de documentation durcies, un discours de scène qui place le contenu produit en série devant l'achat de liens, et une étude qui ne mesure aucun écart entre les marques sans balisage et celles qui en empilent six types. En face, les instruments se fissurent : la moitié des aperçus IA français arrivent après la page, deux façons de mesurer une présence dans ChatGPT ne se recouvrent qu'à 30 %, et une marque peut être citée dans 97,5 % des réponses sans être recommandée une seule fois. Bonne nouvelle au milieu : Gemini étiquette enfin ses liens, et Google a donné ses propres délais de traitement.
- Relecture élargie : Google juge "critique" la vérification humaine des contenus IA, et l'étend aux balises title, aux meta descriptions, aux données structurées et aux textes alternatifs.
- Faux auteurs : fabriquer un profil de créateur avec un portrait généré ou un nom inventé est désormais qualifié de tromperie dans la documentation Google.
- Contenu en série : à Barcelone, Google place le contenu produit à la chaîne devant l'achat de liens dans ses priorités, et rappelle que ses mises à jour visent la page et non le domaine.
- Délais officiels : 20 heures pour découvrir une URL, 30 jours pour en réactualiser une connue, 3 à 6 mois pour sortir d'une core update.
- Mise à jour anti-spam : trois vagues de volatilité depuis le 24 septembre, et Google n'a jamais dit ce que la mise à jour cible.
- Requêtes de marque : les aperçus IA couvrent 82,91 % des recherches de marque aux États-Unis, contre 65,1 % en août.
- Balisage : sans aucun balisage, une marque est recommandée dans 24,2 % des réponses d'IA ; avec six types de balisage, des blocs FAQ et un llms.txt, dans 23,9 %.
- Cité sans être choisi : une marque nommée dans 97,5 % des réponses de découverte reçoit zéro recommandation sur douze questions d'achat.
- Listicles : sur les comparaisons entre deux outils, les éditeurs ne pèsent que 27 % des sources citées, et les listicles 51,1 %.
- Aperçus différés : la moitié des aperçus IA français ne sont pas dans le code servi par Google, mais arrivent par une seconde requête.
- Deux portes : les mêmes 1 000 questions posées par l'accès développeur et par l'interface rendent des listes de marques qui ne se recouvrent qu'à 30 %.
- Taux de clic : il recule sur ordinateur et progresse sur mobile, et la Search Console affiche un taux unique qui masque les deux.
- Filigrane : OpenAI marque les textes de ChatGPT dans l'Union européenne, et écrit lui-même qu'un filigrane ne mesure pas la contribution humaine.
- Pologne : l'autorité de concurrence reproche à Google de négocier la rémunération de la presse sans fournir les données qui permettraient d'évaluer ses offres.
- Shopify : les boutiques éligibles sont inscrites par défaut dans chaque nouveau canal d'achat par agent IA, et doivent se désinscrire.
- Flux RSS : John Mueller recommande un sitemap au nom générique ou un flux RSS pour que les robots d'IA trouvent un contenu, et dit les voir dans ses journaux.
- Multi-pays : le rapport de performances de la Search Console accepte enfin plusieurs pays à la fois.
- Sources préférées : Google envoie par mail le nombre d'abonnés qui ont choisi un site comme source préférée, et ce chiffre n'existe nulle part ailleurs.
- Publicité OpenAI : OpenAI annonce un test de format visuel plus tard ce mois-ci aux États-Unis, pendant la génération d'images de ChatGPT.
Bonne lecture !
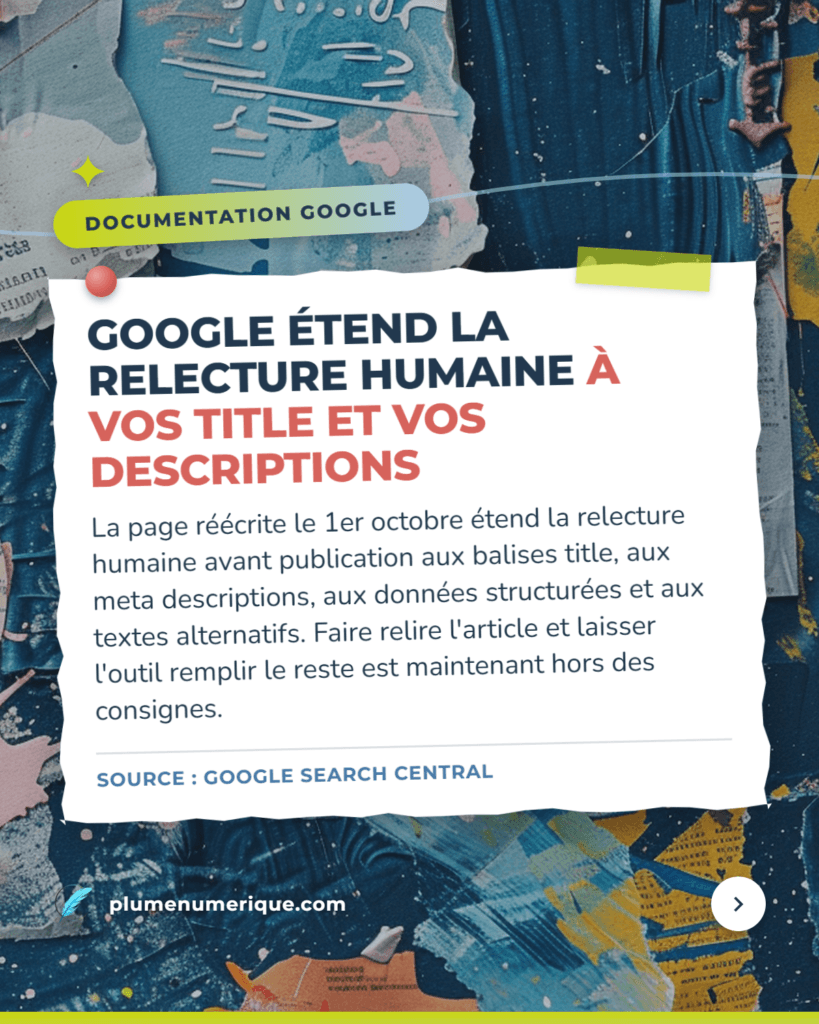
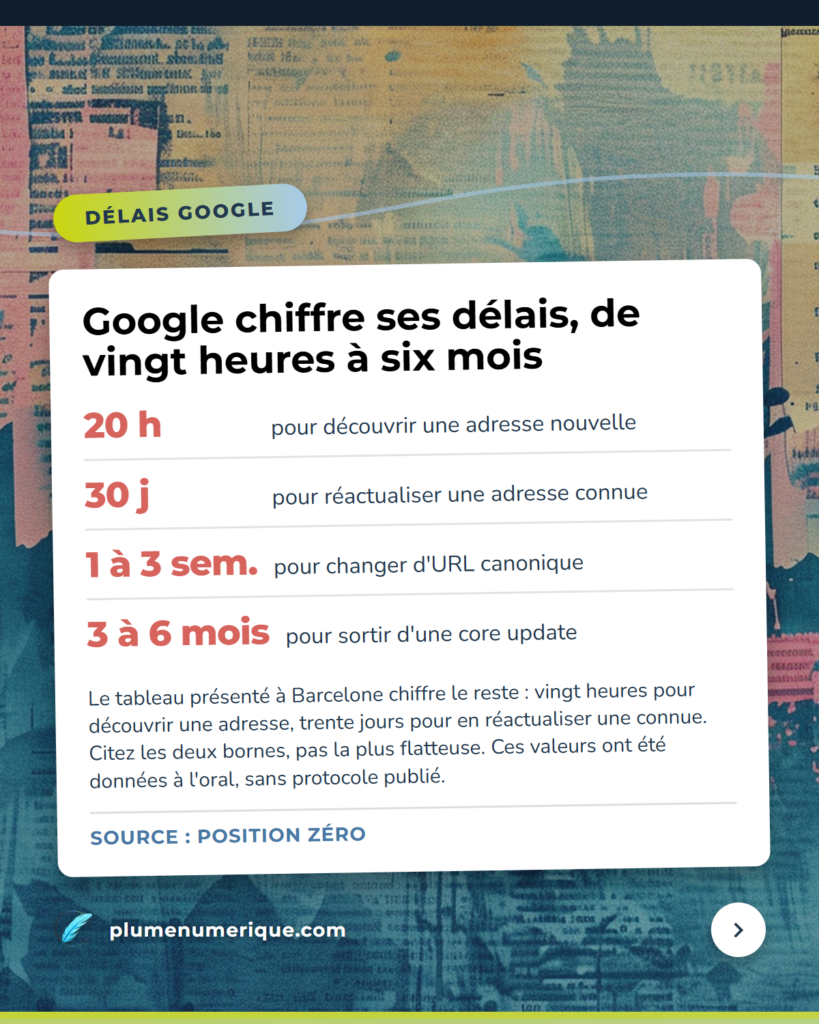
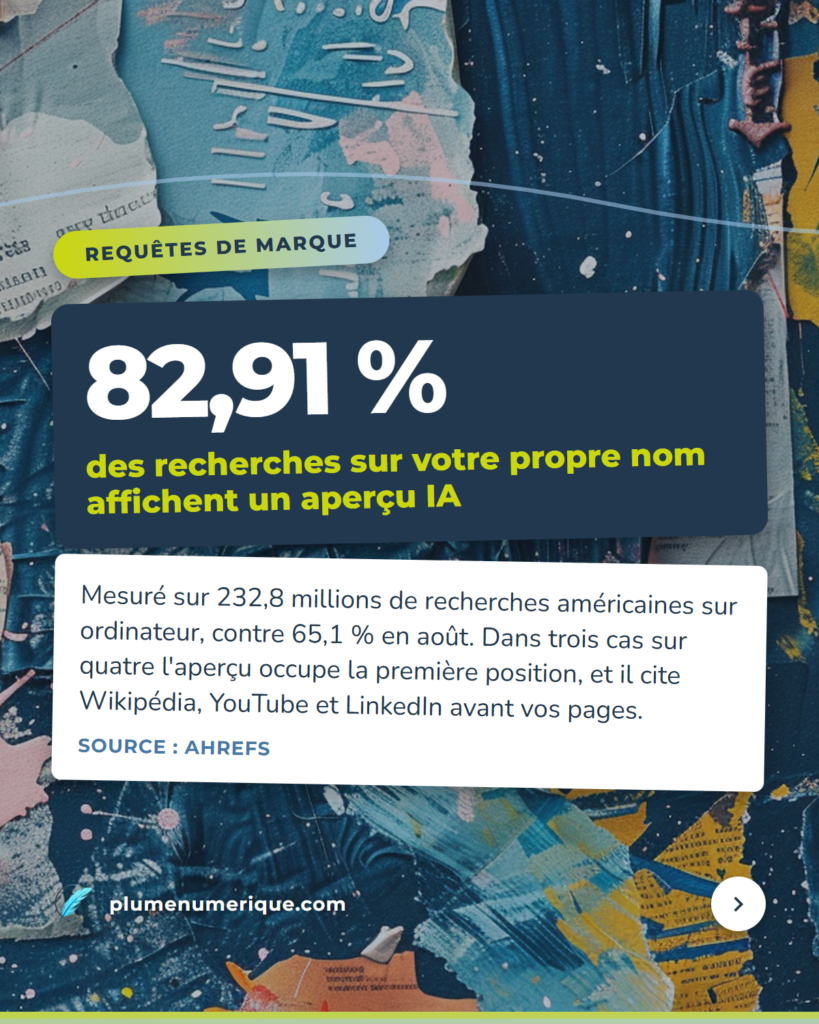
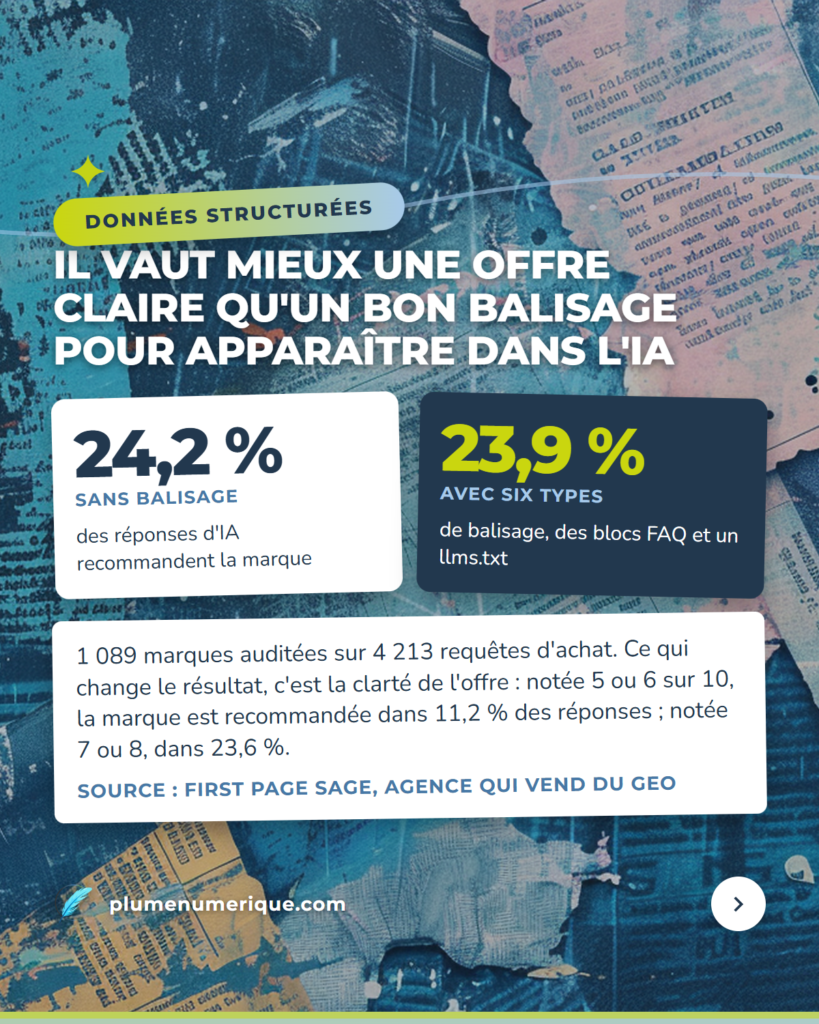
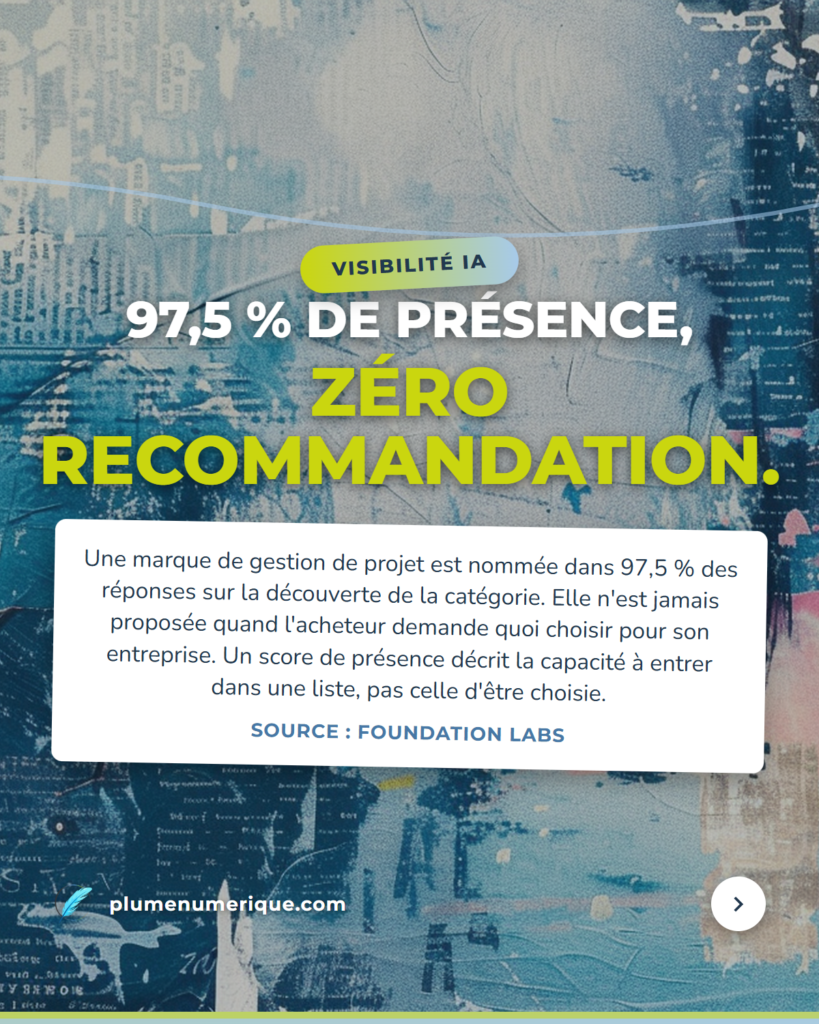
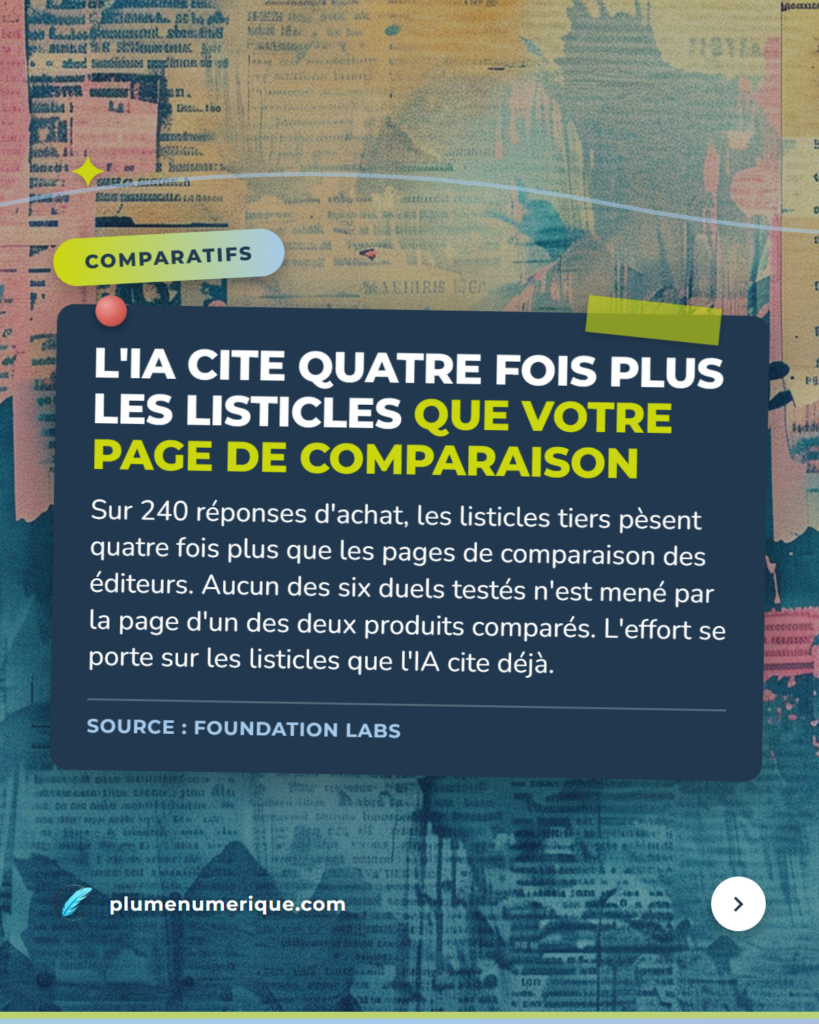
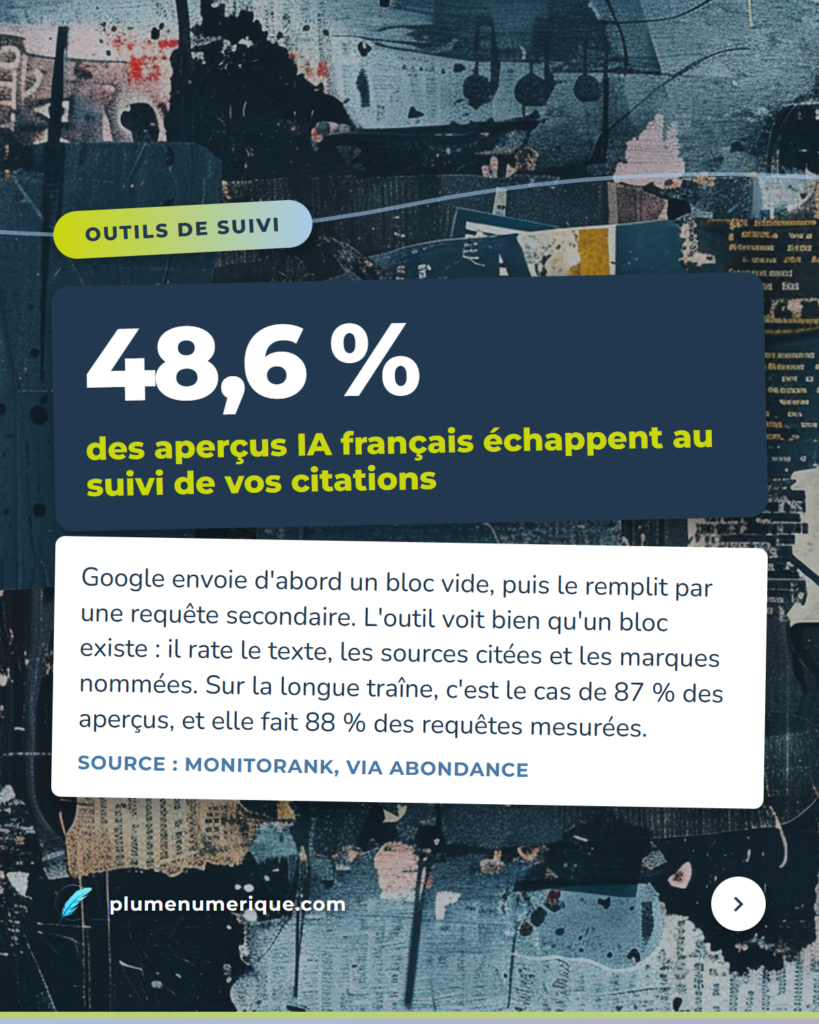
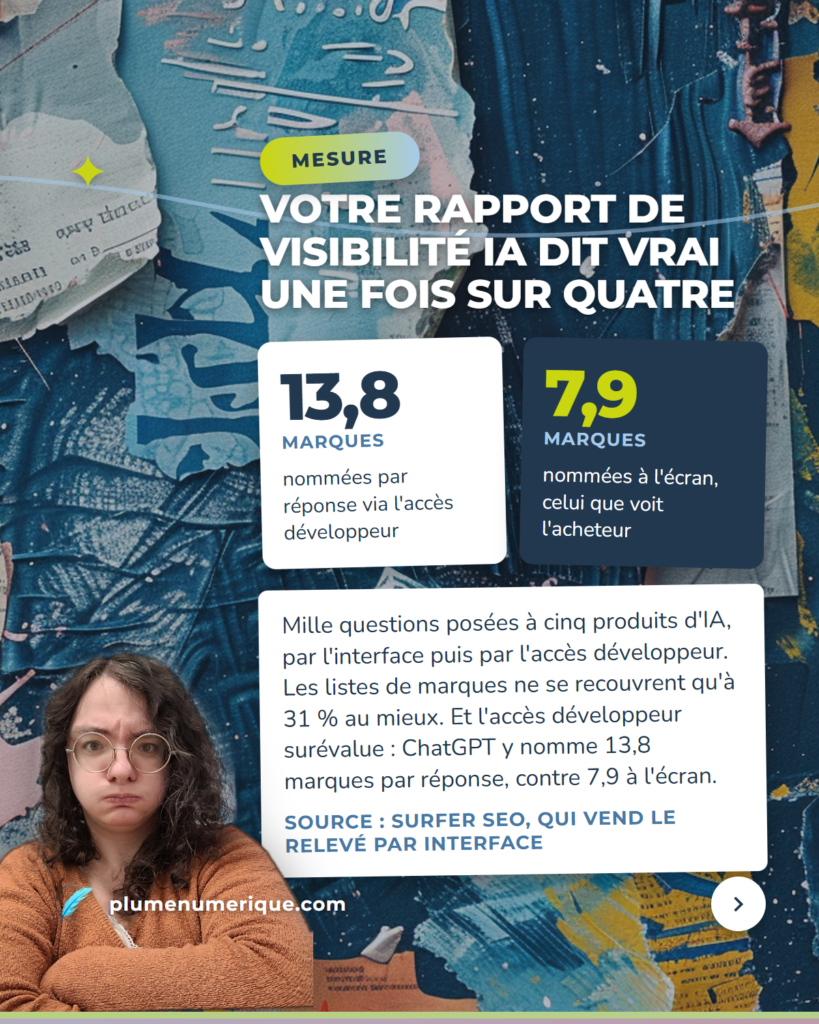
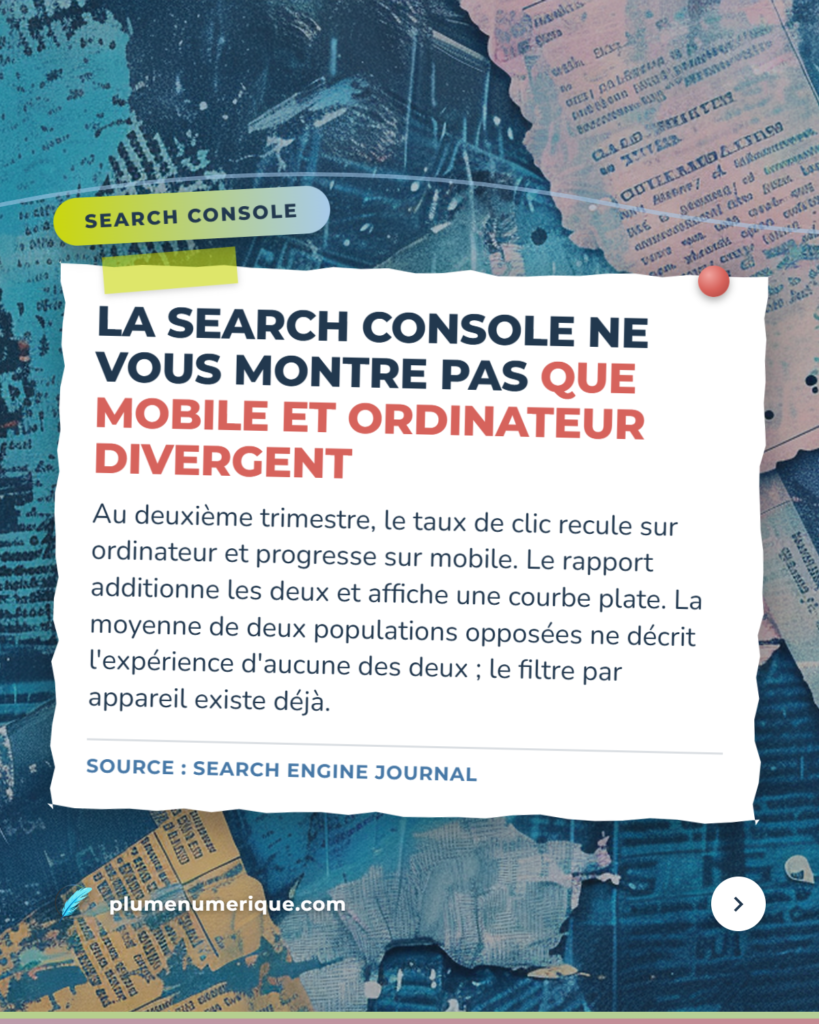
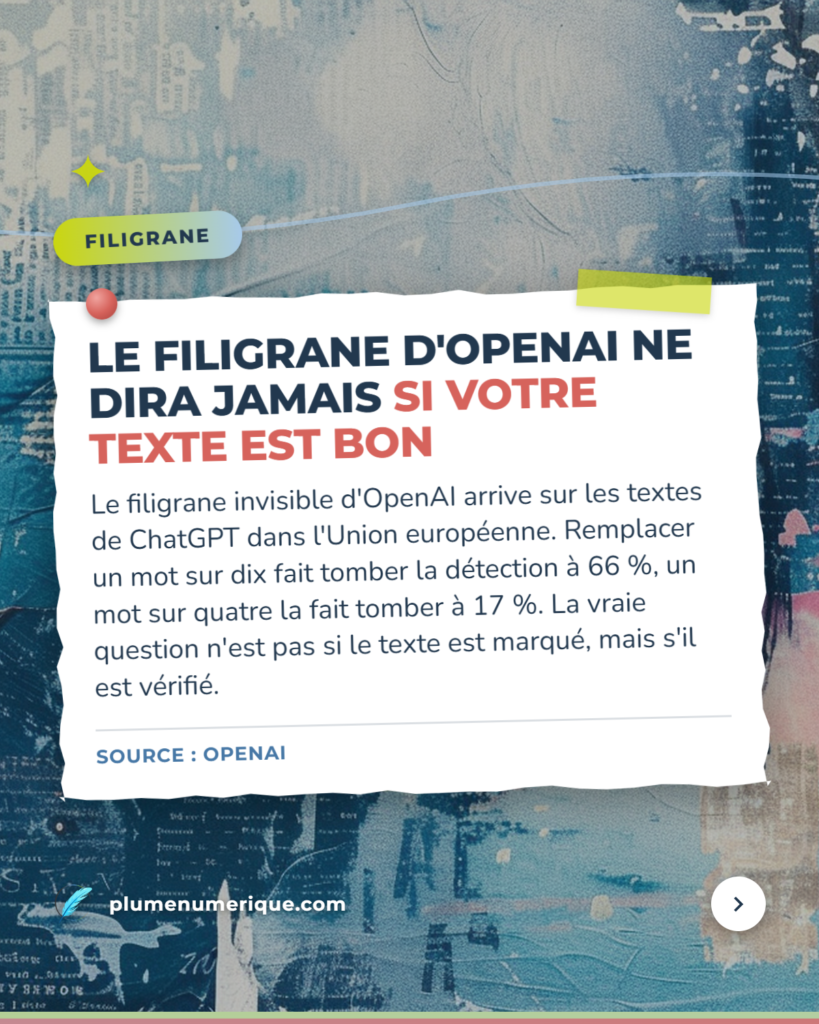
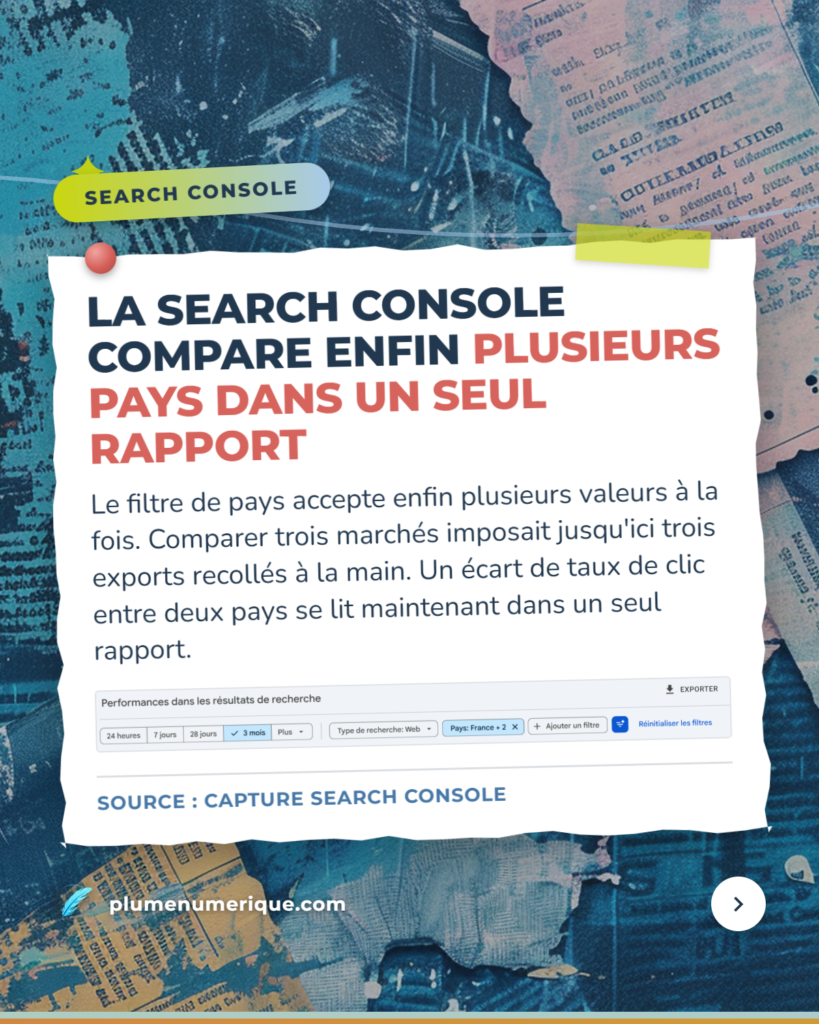
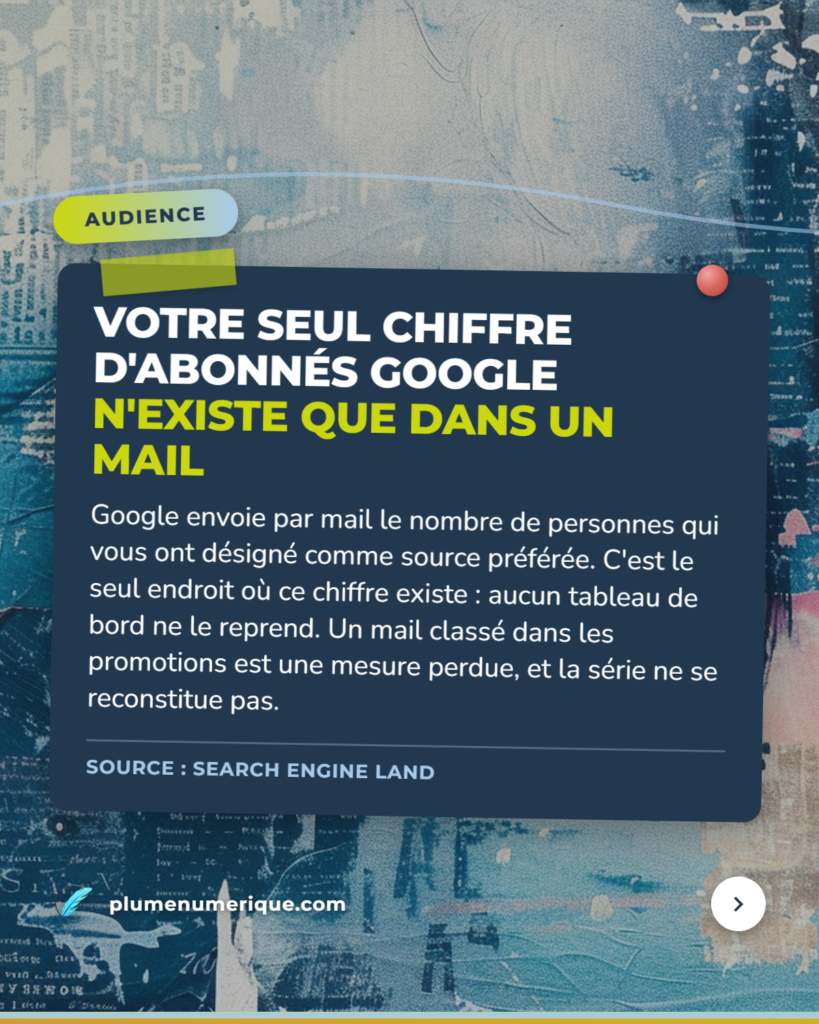
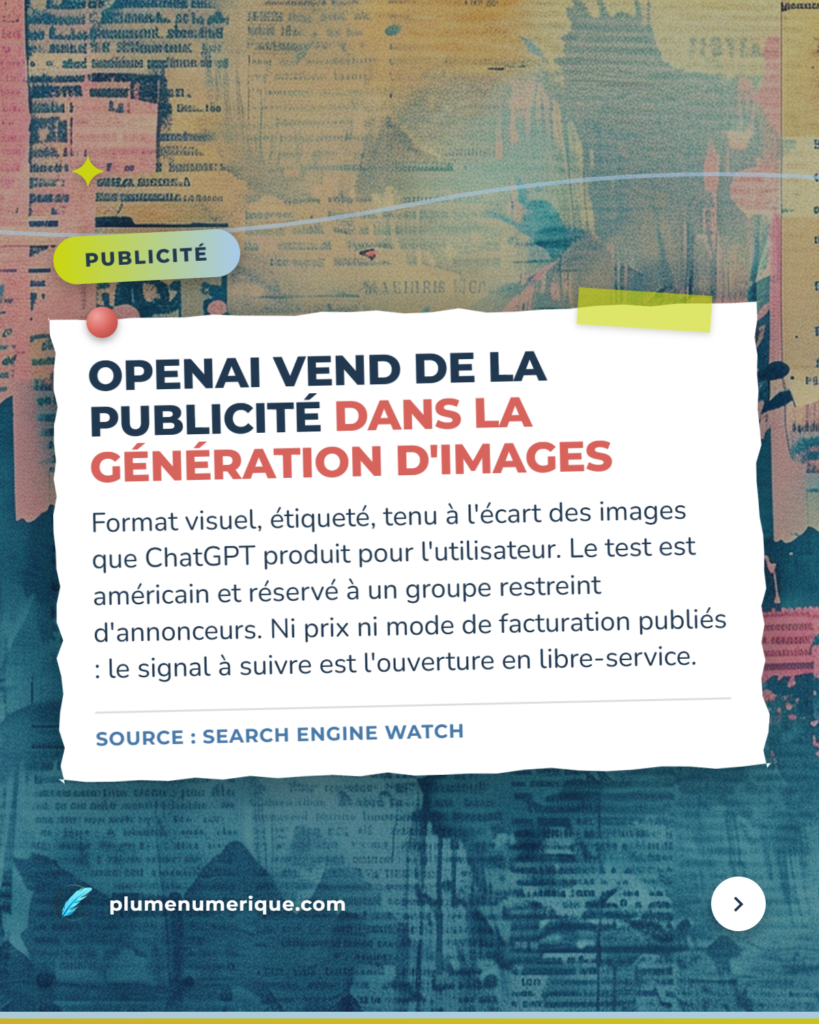
Table des matières
Google étend la relecture humaine à vos title et vos descriptions
Google a réécrit le 1er octobre sa page de documentation sur les contenus générés par IA. La vérification humaine avant publication y devient "critique", et la page précise que cette relecture "s'applique aussi aux métadonnées comme les éléments title, les éléments meta description, les données structurées et les textes alternatifs des images, qui peuvent apparaître dans les résultats de recherche". La même semaine, un sondage d'Ahrefs auprès de 301 professionnels indique que 69 % d'entre eux publient une part plus grande de contenu IA qu'il y a un an. Et que 280 répondants sur 301, soit 93 %, utilisent l'IA pour produire du contenu, contre 87 % l'an dernier.

Qu'est-ce qui change concrètement dans une chaîne de production ? Le périmètre de la relecture. Beaucoup d'équipes font relire l'article par un humain et laissent l'outil remplir le title, la meta description, le balisage et les textes alternatifs. Cette répartition est maintenant hors de la consigne écrite de Google, et c'est la partie la moins relue qui est la plus visible dans les résultats.
Pourquoi Google insiste-t-il sur les métadonnées plutôt que sur le corps ? Parce que ce sont elles qui s'affichent dans la page de résultats. Une erreur factuelle dans un paragraphe se lit par les visiteurs déjà arrivés ; une erreur dans un title se lit par tous ceux qui ne cliqueront pas.
Le volume produit joue-t-il dans l'affaire ? Il la rend urgente. Le sondage et la documentation tombent la même semaine, et ils décrivent les deux faces du même mouvement : la part de contenu assisté augmente chez les producteurs, et le donneur d'ordre resserre ce qu'il exige avant publication.
Le sondage d'Ahrefs est déclaratif et mené par un éditeur d'outils auprès de sa propre audience, ce qui interdit d'y lire une mesure de marché ; Ahrefs précise lui-même que la comparaison avec l'année précédente ne tient qu'au gros grain, son panel ayant changé de taille.
- Créer du contenu utile, fiable et axé sur l'humain Source : Google Search Central
- 69% of Marketers Are Publishing More AI Content Than Last Year Source : Ahrefs
- Google Tells Sites To Fact-Check AI Content Before Publishing Source : Search Engine Journal
- Contenus IA : Google juge désormais "critique" la relecture humaine Source : Abondance
Inventer un auteur devient une forme de tromperie pour Google et un signe de mauvaise qualité de contenu
La page du contenu utile de Google a reçu la même semaine une phrase nouvelle : "évitez d'utiliser des informations d'auteur trompeuses". La documentation nomme ensuite les procédés un par un : "fabriquer des profils de créateurs, par exemple en utilisant des portraits générés par IA, des noms inventés ou de fausses qualifications pour faire croire que le contenu a été écrit par des experts humains, est une forme de tromperie".
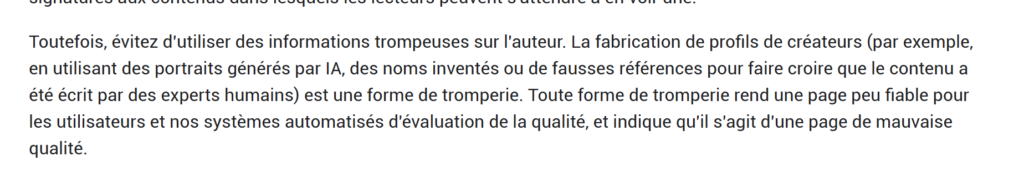
Faut-il désormais signer tous ses articles ? Non, et c'est la nuance qui change la consigne. La même page écrit que Google "encourage vivement" à ajouter des informations d'auteur exactes, "telles que des signatures sur les contenus là où les lecteurs pourraient s'y attendre". L'absence de signature n'est pas sanctionnée ; la signature fabriquée l'est.
Où se situe le risque dans un dispositif éditorial réel ? Dans les fiches auteur créées pour habiller une production externalisée. Un portrait acheté sur une banque d'images reste un portrait réel ; un visage généré accompagné de qualifications inventées entre dans la définition que Google vient d'écrire.
Quel contrôle faire en pratique ? Lister les pages auteur du site et vérifier, pour chacune, que la personne existe et que les compétences affichées sont les siennes. Pour une agence ou un média qui a industrialisé sa production, c'est le seul audit de la semaine qui se fait sans outil.
- Creating Helpful, Reliable, People-First Content Source : Google Search Central
- Google Adds Fake Author Warning To Helpful Content Guidance Source : Search Engine Journal
- Google warns against using fake author information on your content Source : Search Engine Land
- Google Warns Against Deceptive Authorship Information Within Content Source : Search Engine Roundtable
Le contenu produit en série inquiète plus Google que l’achat de liens
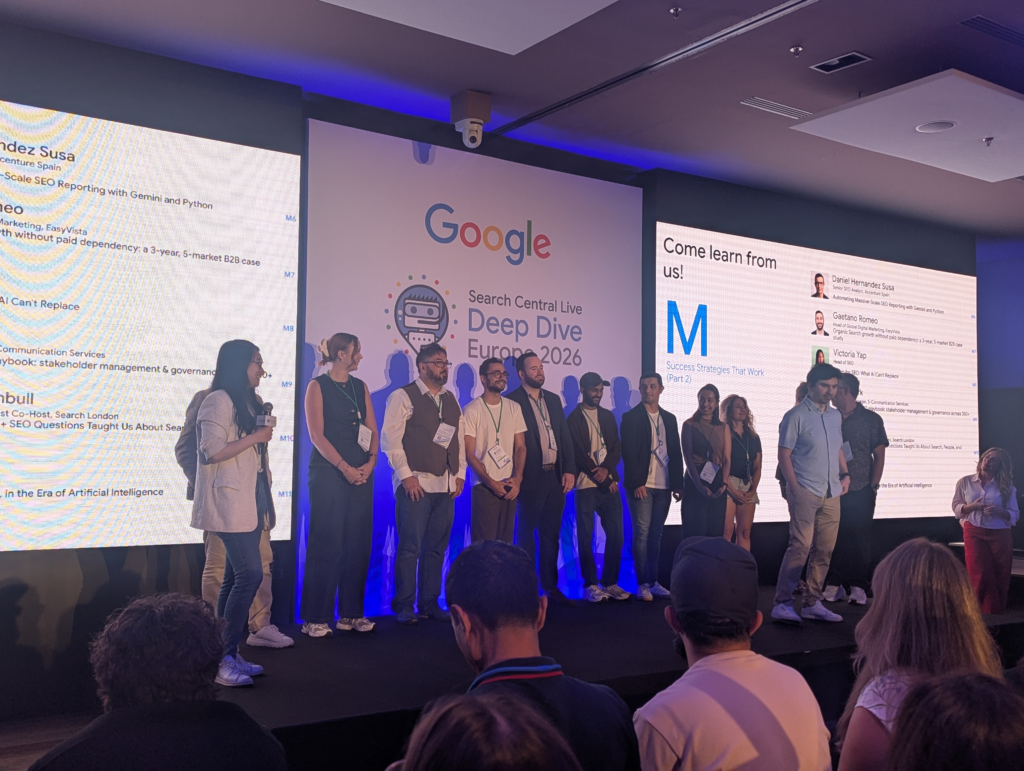
Au Search Central Live Deep Dive de Barcelone, Gary Illyes a prévenu que le contenu produit à grande échelle devient "un problème plus important que le spam de liens". Le compte rendu de la troisième journée, publié par John Campbell, rapporte aussi que Duy Nguyen, analyste qualité chez Google, a renvoyé l'auditoire aux consignes aux évaluateurs et à leurs quatre critères de jugement : l'effort, l'originalité, le talent ou le savoir-faire, et l'exactitude. L'équipe anti-spam utilise maintenant l'IA pour détecter davantage de spam, et construit ses filtres à partir des retours d'utilisateurs.
Pourquoi des pages d'un même site montent-elles quand d'autres descendent ? Parce que les mises à jour anti-spam visent le contenu au niveau de la page, pas du domaine. C'est le point le plus opérationnel de la séance, et il invalide le réflexe le plus courant après une baisse, qui consiste à chercher une cause valable pour tout le site là où le diagnostic se fait page par page.
Comment Google distingue-t-il un contenu à effort d'un contenu produit en série ? Les exemples donnés sur scène sont concrets : une critique de chaussures bâtie sur ses propres mesures, ses propres photographies et une recherche détaillée, contre du contenu réécrit sans apport. Le guide du contenu utile range désormais explicitement l'usage de l'IA pour produire du volume sans supervision ni sélection humaine dans la catégorie du faible effort.
L'IA est-elle visée en tant que telle ? Non. La position rapportée est que la qualité compte, pas l'auteur, et qu'un contenu de faible qualité peut être humain comme généré.
Aucune transcription officielle de Google n'existe pour cet événement, et il n'y a donc pas de pièce primaire à opposer au compte rendu : les citations ci-dessus sont celles d'un auditeur, fidèles à ce qu'il a entendu mais non validées par Google.
- Google Search Central Live Deep Dive, Barcelona – Day 3 Recap Source : ROAST
- Google Search Spam Updates Use AI To Find AI Spam & More Source : Search Engine Roundtable
- Google Says Scaled Content Is Now a Bigger Problem Than Link Spam Source : Page One Power
- Pour Google, l'effort d'un contenu ne se mesure pas au temps passé Source : Position Zéro
Google chiffre ses délais : vous avez besoin de trois à six mois pour sortir d’une core update
Toujours à Barcelone, Gary Illyes a présenté un tableau des délais de traitement de Google, avec pour chaque opération un cas habituel et un cas le plus lent. Une URL nouvelle est découverte en 20 heures environ, et l'écart est considérable : le cas le plus lent se compte en "plusieurs semaines, voire jamais". L'actualisation d'une URL déjà connue demande une trentaine de jours. Le traitement d'un sitemap prend environ 24 heures, jusqu'à 14 jours, "voire jamais selon la qualité". Une indexation de bout en bout tient en une heure et demie dans le cas habituel, et en plusieurs mois dans le pire.
Combien de temps pour qu'un changement de title soit pris en compte ? Un à deux jours dans le cas habituel, plusieurs semaines à plusieurs mois dans le cas le plus lent. Même fourchette pour la modification d'un extrait. Une suppression demandée dans la Search Console est beaucoup plus rapide : environ deux heures, et jusqu'à 24.
Et pour une migration ou un changement d'adresse de référence ? Un changement d'URL canonique, celle que Google retient quand plusieurs adresses servent le même contenu, prend une à trois semaines, et plusieurs mois en présence de signaux contradictoires entre le contenu, les liens, les redirections et les balises. La levée d'une action manuelle demande une à deux semaines, quatre à six dans le cas lent, davantage pour un site inactif. La reprise après une core update se compte en trois à six mois.
Que faire de ces chiffres face à un client ? Les opposer à une attente de résultats à six semaines après une refonte. Mais il faut citer les deux bornes, pas la plus flatteuse : l'écart entre "20 heures" et "voire jamais" est précisément ce que ces chiffres apprennent, et ce qui fait basculer de l'une à l'autre est la qualité perçue du site.
Google a livré ces valeurs à l'oral, sans échantillon, sans protocole et sans publication : un membre de l'équipe Search Relations a donné des ordres de grandeur, et rien ne permet de les vérifier.
- Crawl, indexation, migration : les délais donnés par Google Source : Position Zéro
- Google: How Long It Takes Google Search For Crawling, Indexing & Serving Source : Search Engine Roundtable
- Google Shows How Long Crawling, Indexing & Recovery Can Take Source : Search Engine Journal
Google n’a jamais dit ce que visait sa mise à jour anti-spam de septembre 2026
La mise à jour anti-spam de septembre est partie le 24 septembre, dans le monde entier et dans toutes les langues. C'est la quatrième de l'année, et Google a prévenu que son déploiement pourrait prendre deux semaines, là où les trois précédentes s'étaient achevées en moins de trois jours. Barry Schwartz a demandé à John Mueller si le texte ne devait pas dire deux jours plutôt que deux semaines, en rappelant que les trois mises à jour anti-spam précédentes avaient duré environ deux jours et que les core updates tournent autour de deux semaines. Mueller a répondu que ce serait "probablement plus long que certaines des précédentes".
Yes, it's likely to take longer than some of the previous ones.
— John Mueller (@johnmu.com) 2026-09-24
Les outils de suivi relèvent depuis trois vagues de volatilité : du 25 au 27 septembre, le 30 septembre, puis entre le 4 et le 6 octobre.
Que cible exactement cette mise à jour ? Google ne l'a pas dit, et c'est l'information de la rubrique. Il n'a pas non plus établi de lien avec le changement de sa politique d'abus de réputation de site du 28 août, alors que c'est la première mise à jour anti-spam qui la suit. Les seuls éléments de cadrage viennent de Barcelone : détection assistée par IA, et filtres construits à partir des retours d'utilisateurs.
Peut-on s'appuyer sur les relevés de sites touchés ? Avec une précaution dirimante. Le relevé le plus repris, celui de Glenn Gabe, porte sur environ 1 500 sites, mais ce suivi regroupe des domaines déjà touchés par des mises à jour anti-spam et des sites au profil similaire. C'est un panel délibérément orienté vers les sites à risque : il décrit ce qui arrive à ces sites-là, et ne permet aucune extrapolation à une population.
Quelle fenêtre filtrer dans la Search Console ? Celle des trois vagues, et non la date d'annonce seule. Position Zéro écarte explicitement de sa chronologie les mouvements antérieurs au 24 septembre, dont une chute début septembre suivie d'un rebond le 13 : les attribuer à cette mise à jour fausserait le diagnostic.
- Google September 2026 Spam Update: What to watch Source : Semrush
- Spam Update : que montrent les mouvements du 4 au 6 octobre ? Source : Position Zéro
- Final Phase Of Google September 2026 Spam Update Rollout Oct 4-6? Source : Search Engine Roundtable
- Spam update de septembre : un week-end très agité Source : Position Zéro
Huit recherches sur dix de votre marque affichent une réponse IA
Ahrefs a analysé 232,8 millions de recherches Google sur ordinateur aux États-Unis. Au 29 septembre 2026, un aperçu IA s'affichait sur 82,91 % des résultats pour des requêtes de marque, contre 65,1 % en août. Dans 76,2 % des cas, cet aperçu occupait la première position de la page. Les citations externes les plus fréquentes dans ces aperçus de marque sont Wikipédia, YouTube et LinkedIn. Un second jeu de données, publié par DemandSphere et relayé par Semrush, décrit la même bascule : 26,12 % des requêtes de marque suivies le 1er septembre, un pic à 90,48 % le 27, et 82,06 % le 29.
Qu'est-ce que ça change pour une marque qui rankait déjà première sur son nom ? La première position existe toujours, mais elle n'est plus en haut de page dans trois cas sur quatre. Ce que le visiteur lit d'abord est un résumé construit à partir de sources tierces, et les trois sources les plus citées sont des plateformes sur lesquelles la marque n'a qu'un contrôle partiel.
Les deux mesures sont-elles comparables ? Elles concordent sur la tendance et sur l'ordre de grandeur de fin septembre, pas sur le détail. Ahrefs ne regarde que l'ordinateur et les États-Unis ; DemandSphere couvre tous les marchés et tous les appareils, mais, comme Semrush l'écrit, "n'a pas dit combien de mots-clés il suit". Faute de savoir sur combien de requêtes ce taux est calculé, le second chiffre vaut comme signal de tendance, pas comme mesure.
Par quoi commencer ? Par taper ses dix requêtes de marque principales et lire ce que l'aperçu dit de l'entreprise, en notant les sources citées. Une demi-heure suffit, et le résultat détermine le chantier : corriger une fiche Wikipédia ou une page LinkedIn n'est pas le même travail que réécrire ses propres pages.
- AI Overviews Currently Appear for 83% of Branded Searches Source : Ahrefs
- Google AI Overviews now appear for most major brands Source : Semrush
Il vaut mieux une offre claire qu’un bon balisage pour apparaître dans l’IA
First Page Sage a passé 4 213 requêtes commerciales dans ChatGPT, Google Gemini et Claude entre le 8 juin et le 18 septembre 2026, et confié 657 tâches de sélection et d'achat à des agents. Pour chacune des 1 089 marques apparues dans ces réponses, l'équipe a audité la structure des données, noté la clarté de l'offre sur une échelle de 1 à 10, et mesuré la cohérence des informations entre le site de la marque et les sources tierces. Le balisage schema, ce code invisible ajouté aux pages pour décrire leur contenu aux machines, fait progresser le taux de recommandation de 3,7 points en apparence ; une fois l'autorité des marques tenue constante, il n'en reste que 0,4 point de pourcentage. Le balisage FAQ rend 0,3 point de moins, le fichier llms.txt 0,1 de moins, et l'étude écrit qu'ils ne montrent "aucun effet mesurable".
Qu'est-ce qui produit un effet, alors ? Deux choses, et aucune n'est technique. Dire clairement ce que l'on vend et à qui vaut 11,2 points de taux de recommandation. Dire la même chose sur son site et dans les sources tierces en vaut 9,4. Le seuil compte autant que la direction : les marques notées 5 ou 6 en clarté sont recommandées dans 11,2 % des cas, celles notées 7 ou 8 dans 23,6 %. Le taux double au passage de 7.
Empiler du balisage peut-il nuire ? L'étude ne le dit pas, mais elle mesure que ça ne sert à rien. Parmi les marques les plus claires, celles qui déploient six types de balisage ou plus, avec des blocs FAQ et un llms.txt, sont recommandées dans 23,9 % des cas ; celles qui n'ont aucun balisage, dans 24,2 %. Pour une direction qui arbitre un budget, c'est l'écart le plus utile de l'étude : il est nul.
Y a-t-il un chantier de structuration qui rapporte vraiment ? Oui, et ce n'est pas celui qu'on vend. Rendre lisibles par une machine les informations que l'acheteur cherche produit les plus forts écarts. Un chemin de réservation ou de paiement lisible par une machine vaut 17,4 points de plus qu'un équivalent en texte clair. Et un prix lisible par une machine fait présélectionner la marque par un agent dans 31,4 % des cas, contre 22,8 % en texte clair seul et 9,7 % quand le prix est absent ou derrière un formulaire.
L'agence qui publie cette étude vend des prestations d'optimisation pour les moteurs génératifs, elle garde son modèle de pondération de l'autorité pour elle, et elle ne donne ni mesure de dispersion ni intervalle de confiance : les écarts sont exploitables comme ordres de grandeur, pas comme valeurs.
- Impact of Structured Data on AI Rankings: 2026 Study Source : First Page Sage
- Quel rôle jouent les données structurées dans les recommandations des IA ? Source : Position Zéro
97,5 % de présence dans les réponses IA, zéro recommandation à l’achat
Foundation a posé 21 questions, deux fois chacune, à ChatGPT, Claude, Gemini, Perplexity, Google AI Overview et Google AI Mode, soit 252 réponses, en suivant une seule marque de logiciel de gestion de projet. L'équipe a réparti ses questions en cinq groupes, dont deux comptent ici. Sur les dix premières, qui portent sur la découverte de la catégorie et les usages de l'IA, la marque est nommée dans 97,5 % des réponses sans que la question la mentionne. Sur les douze questions d'évaluation par un acheteur, où la recommandation est demandée pour une entreprise de 100 personnes, elle n'est recommandée aucune fois.
Pourquoi un tableau de bord de visibilité IA ne voit-il pas cet écart ? Parce qu'il mesure la première famille de questions. Un score de présence élevé décrit la capacité d'une marque à entrer dans une liste, et ne dit rien de sa capacité à être choisie quand la question devient un arbitrage. Les deux se mesurent séparément ou pas du tout.
Le résultat est-il uniforme d'une surface à l'autre ? Non, et c'est l'autre apport de l'étude. Sur une échelle de sentiment allant de moins deux à plus deux, cinq des six surfaces sont au-dessus du neutre, Claude exactement au neutre, et aucune en dessous. L'équipe publie sa règle de codage, ce qui permet de rejouer le calcul.
Quel test faire sur sa propre marque ? Poser les deux familles de questions plutôt qu'une seule : celle qui fabrique une liste, puis celle qui demande un choix avec une contrainte réelle, taille d'entreprise ou budget. L'écart entre les deux réponses est le diagnostic.
Une agence de conseil en visibilité IA signe cette étude, elle porte sur un seul annonceur, et personne ne l'a reproduite : elle vaut comme démonstration d'un mécanisme, pas comme mesure d'un marché.
- Model Drift: Why ClickUp Looks Different Across Six AI Surfaces Source : Foundation Labs
L’IA cite quatre fois plus les listicles que votre page de comparaison
Même équipe, autre étude : 20 questions d'achat posées deux fois à six systèmes d'IA, 240 réponses collectées, 2 695 présences de sources relevées, sur le marché des logiciels de gestion des candidatures. Sur les six comparaisons directes entre deux produits concurrents, les quatre éditeurs concernés ne totalisent que 27 % de la présence visible des sources, et 73 % viennent d'ailleurs. Aucune des six comparaisons n'est menée par la page "X contre Y" de l'un des deux produits comparés. Sur les dix questions de catégorie, les listicles, ces articles du type "les 10 meilleurs outils de", pèsent 51,1 % de la présence des sources, contre 12,6 % pour les pages de comparaison dédiées.
Faut-il arrêter d'écrire des pages de comparaison ? Pas nécessairement, mais il faut cesser d'en attendre qu'elles gagnent la comparaison. Sur cette mesure, elles pèsent quatre fois moins que les listicles tiers, et elles ne mènent aucun des duels où leur propre produit est en jeu.
Où porter l'effort à la place ? Sur les listicles que l'IA cite déjà pour les questions de catégorie du marché visé. Le travail devient alors un travail de relations et de présence dans des contenus tiers plutôt qu'un travail de production de pages.
Quel trait partagent les pages qui apparaissent le plus ? L'étude relève qu'elles exposent tôt l'adéquation à l'acheteur, les critères de décision, les compromis et une recommandation, plutôt que de les garder pour la fin.
Même réserve que pour l'étude précédente : l'éditeur vend du conseil en visibilité IA, et la mesure porte sur un seul marché vertical.
- 4 ATS vendors own 27% of the AI sources. Here's how AI picks the rest Source : Foundation Labs
Un aperçu IA sur deux échappe au suivi de vos citations
Monitorank a relevé 2 millions de pages de résultats françaises, sur un million de mots-clés, sur ordinateur et sur mobile, du 9 au 14 septembre 2026. Dans ce périmètre, 50,8 % des recherches affichent un aperçu IA. Et parmi ces aperçus, 48,6 % ne sont pas livrés avec la page : le code HTML initial envoyé par Google ne contient qu'un bloc vide, complété ensuite par une requête secondaire.
Quels outils sont concernés ? Ceux qui lisent le code servi par Google sans exécuter la suite. Ils voient bien qu'un bloc existe, donc leur relevé de présence reste bon ; ce qu'ils ratent, c'est le texte de la réponse, les sources citées et les marques mentionnées. Un outil qui rend la page comme un navigateur les récupère. La distinction n'est pas entre bons et mauvais outils, elle est entre deux méthodes de collecte, et c'est elle qu'il faut faire préciser avant de croire un rapport de citations.
Le phénomène est-il uniforme ? Non, et c'est ce qui le rend gênant. La part d'aperçus chargés après la page atteint 86,9 % sur ordinateur pour les requêtes à moins de 100 recherches annuelles, puis redescend vers 25 % au-delà de 10 000. Or les requêtes sous 5 000 recherches représentent environ 88 % du corpus mesuré : sur la longue traîne, le chargement différé est la norme et non l'exception.
Pourquoi Google procède-t-il ainsi ? La page se charge sans attendre que le résumé soit prêt, puis le bloc se remplit. L'article n'avance pas d'explication officielle, et il n'y en a pas de publiée.
Que demander à son prestataire ? Une seule question : relevez-vous le code servi ou la page rendue ? Une réponse vague sur ce point suffit à disqualifier un rapport de présence dans les aperçus IA, parce que l'écart possible atteint la moitié du phénomène mesuré.
Les chiffres décrivent la situation du 9 au 14 septembre 2026, et Abondance signale cette limite de fenêtre de collecte dans son relais. Le périmètre est celui de la base de mots-clés de l'éditeur, pas celui des recherches du marché français.
- AI Overviews : 48,6 % se chargent après la page, un angle mort pour le suivi des citations Source : Abondance
Votre rapport de visibilité IA dit vrai une fois sur 4
Surfer a posé les mêmes 1 000 questions à cinq produits d'IA de deux façons : une fois en relevant l'interface que voit un utilisateur réel, une fois par l'accès réservé aux développeurs. L'exercice a produit 13 779 réponses. Les listes de marques citées par les deux méthodes ne se recouvrent que de 15,5 % à 23,8 %, et de 21,3 % à 31,6 % après normalisation des noms de marque. L'éditeur résume ainsi la conséquence : en mesurant une part de voix sur les données de l'accès développeur, "vous n'avez qu'environ une chance sur quatre que votre rapport recouvre ce que votre acheteur voit".
D'où vient un écart aussi large sur les mêmes questions ? Les deux portes ne déclenchent pas les mêmes comportements. L'accès développeur de ChatGPT a lancé une recherche web sur 83 % des questions, celui de Gemini sur 85 %, et ceux de l'AI Mode et des aperçus IA sur 94 %. Quand les sources consultées diffèrent, les marques citées diffèrent.
Comment savoir quelle méthode utilise son outil ? En le demandant. C'est la seule question à poser, et l'incapacité à y répondre est en soi une réponse sur la valeur du chiffre livré.
Ce défaut se cumule-t-il avec d'autres ? Oui, et c'est ce qui le rend coûteux. Un rapport peut se tromper deux fois : sur la méthode de collecte, comme ici, et sur la question posée. La mesure de Foundation citée plus haut dans cette revue le montre : une marque présente dans 97,5 % des réponses de découverte n'y reçoit aucune recommandation à l'achat. Un score élevé obtenu par l'accès développeur sur des questions de découverte ne garantit donc rien du tout.
L'éditeur qui publie cette mesure fonde précisément son outil sur le relevé d'interface : il mesure donc que la méthode de ses concurrents s'écarte de la sienne, et cet intérêt doit être connu avant de reprendre le chiffre.
- Why You Cannot Track AI Visibility Through an API Source : Surfer SEO
- Model Drift: Why ClickUp Looks Different Across Six AI Surfaces Source : Foundation Labs
La Search Console ne vous montre pas que mobile et ordinateur divergent
Les données du deuxième trimestre montrent un taux de clic en recul sur les résultats Google sur ordinateur, et en progression sur mobile. Les deux mouvements sont de sens contraire sur la même période.
Qu'affiche la Search Console dans ce cas ? Un taux de clic unique, qui additionne les deux. Le rapport produit alors une courbe sans relief, et le lecteur conclut à la stabilité là où deux tendances opposées se compensent. Rien dans l'interface ne signale cette compensation.
Combien de temps coûte la correction ? Le temps d'appliquer un filtre. La segmentation par appareil existe dans le rapport de performances, elle n'est simplement pas appliquée par défaut, et aucun écran ne suggère de l'appliquer.
Pourquoi ce cas revient-il si souvent ? Parce que c'est le même mécanisme chaque fois : un rapport qui agrège deux populations aux comportements divergents affiche leur moyenne, et la moyenne ne décrit l'expérience d'aucune des deux. C'est vrai des appareils, des pays et des types de requêtes, et c'est pour cette raison qu'un rapport par défaut est rarement un rapport exploitable.
- Google Desktop CTR Fell In Q2 While Mobile Rose, Data Shows Source : Search Engine Journal
- CTR Google : le desktop recule, le mobile progresse au deuxième trimestre Source : Position Zéro
Le filigrane d’OpenAI ne dira jamais si votre texte est bon
OpenAI a publié le 5 octobre son approche des règles européennes de traçabilité des textes. Un filigrane invisible va être appliqué aux textes éligibles de ChatGPT et de Codex, dans l'Union européenne seulement et dans les semaines qui viennent. Le marquage restera désactivé par défaut dans l'interface de programmation, et le détecteur n'est pas ouvert au public au lancement. OpenAI publie aussi ce que vaut sa détection. Sur des passages de 400 jetons, soit environ 300 mots, et à un taux de faux positifs cible de 1 %, c'est-à-dire en acceptant une fausse alerte sur cent, remplacer 10 % des mots par des synonymes fait tomber la détection d'environ 92 % à 66 %. En remplacer 25 % la fait tomber à 17 %.
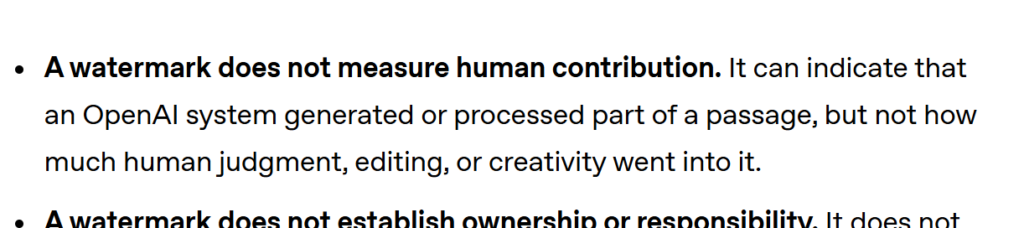
Ce filigrane permet-il de contrôler une production éditoriale ? Non, et OpenAI l'écrit en deux phrases qui ferment le débat : "un filigrane ne mesure pas la contribution humaine", et "l'absence de filigrane détecté ne prouve pas qu'un humain en est l'auteur". Un filigrane renseigne sur la machine par laquelle un texte est passé. Il ne dit rien de sa justesse, de son utilité, ni du travail investi, c'est-à-dire exactement ce que Google demande d'évaluer depuis le 1er octobre.
Faut-il en tirer une consigne pour son équipe ? Une seule, et elle ne porte pas sur la détection : la question utile n'est pas de savoir si un texte a été marqué, mais s'il a été vérifié. Un processus de contrôle bâti sur un détecteur se heurtera à deux murs, sa fragilité et son indisponibilité, alors qu'une relecture factuelle documentée répond à la fois à l'exigence écrite de Google et au besoin réel du lecteur.
Le périmètre crée-t-il un effet de bord ? Oui. Anthropic marque ses modèles compatibles dans le monde entier, OpenAI dans l'Union européenne seulement. Une même équipe produira donc du texte marqué en Europe et non marqué ailleurs, ce qui retire au filigrane toute valeur de preuve dans un dispositif international.
- Our approach to EU text provenance rules Source : OpenAI
- OpenAI To Watermark ChatGPT Text In The EU, Opens API Opt-In Source : Search Engine Journal
- Les textes générés par ChatGPT vont intégrer un filigrane invisible Source : Blog du Modérateur
- Les textes de ChatGPT seront bientôt reconnaissables grâce à un filigrane invisible Source : Siècle Digital
La Pologne attaque Google sur les données que les éditeurs n’ont pas
L'UOKiK, l'autorité polonaise de la concurrence et de la protection des consommateurs, a ouvert une procédure contre Google. Le reproche ne porte pas sur le montant des offres faites aux éditeurs de presse, mais sur ce qui les accompagne : selon l'autorité, Google n'a pas expliqué comment il utilisait les contenus de presse ni quels revenus il en tirait. L'autorité précise qu'elle examine la conduite des négociations et qu'elle ne juge pas si les tarifs proposés sont adéquats. La procédure couvre les négociations portant sur Search, News et Discover, et l'annonce ne contient aucun constat de responsabilité ni sanction.
En quoi l'absence de données change-t-elle la négociation ? Elle détermine ce qu'un éditeur peut contester. Sans savoir comment son contenu est utilisé et ce qu'il rapporte, un éditeur reçoit une offre qu'il peut accepter ou refuser, mais pas discuter. C'est le déséquilibre d'information, et non le prix, que l'autorité instruit.
Que se passe-t-il si les parties ne s'entendent pas ? En Pologne, l'office des communications électroniques, l'UKE, peut fixer la rémunération. L'existence de ce recours change la position de départ de chaque camp.
Le dossier français en est-il au même point ? Il est plus avancé et il porte désormais sur l'IA. La France a été le premier pays à transposer le droit voisin, qui oblige les moteurs à rémunérer les éditeurs dont ils reprennent le contenu, et l'Autorité de la concurrence a déjà sanctionné Google pour n'avoir pas respecté ses engagements de négociation de bonne foi. Depuis le déploiement des aperçus IA et de l'AI Mode en France cet été, le débat s'est déplacé vers la rémunération des contenus utilisés par ces résumés, sujet que nous traitions dans l'édition de la semaine du 10 août. La Commission européenne mène de son côté une enquête ouverte en décembre 2025 sur la compensation et les possibilités de retrait des éditeurs pour les usages IA, aperçus IA et AI Mode compris.
- Poland accuses Google of making publishers negotiate blind over news payments Source : Search Engine Watch
Shopify expose vos produits aux assistants IA sans vous demander
Un réglage nommé "Allow Shopify to manage for me" se trouve en tête de la section Sales channels, onglet Agentic, de l'administration Shopify, et il reste actif tant qu'on ne le désactive pas. La documentation de Shopify décrit ce qu'il fait : les canaux de vitrines agentiques, c'est-à-dire les assistants qui parcourent un catalogue et achètent à la place de l'internaute, accèdent aux produits via Shopify Catalog, le paiement direct est activé pour les canaux concernés, et la boutique est inscrite automatiquement dans les nouveaux canaux de vitrines agentiques. Ce réglage n'est pas nouveau : Shopify a commencé à y inscrire les marchands automatiquement le 12 janvier 2026. C'est par ce mécanisme que Shopify a transmis à Meta les produits des boutiques éligibles le 8 septembre 2026, jour du lancement de son application Muse, et Amazon a bloqué Muse de sa propre boutique le 20 septembre, douze jours plus tard.
Quels canaux sont concernés aujourd'hui ? ChatGPT, Google, Copilot et Meta, chacun avec son interrupteur d'accès au catalogue et son interrupteur de paiement direct. S'y ajoute une ligne "Other channels". L'administration la décrit comme les "autres plateformes propulsées par l'IA, comme Perplexity, qui peuvent présenter vos produits aux acheteurs". La page d'aide y range les "développeurs indépendants et startups qui construisent des agents d'achat de niche ou expérimentaux" et les "nouveaux partenaires tiers ayant récemment obtenu l'accès à Shopify Catalog pour des tests". Aucun de ces canaux ne facture de frais à ce jour.
Comment se retirer, et à quel prix ? En désactivant le réglage global, ce qui fait apparaître trois interrupteurs distincts : accès au catalogue, inscription automatique aux nouvelles vitrines, et paiement direct. Shopify prévient que la coupure de l'accès au catalogue peut demander "jusqu'à 7 jours avant que vos données produit ne soient plus partagées".
Peut-on retirer un seul produit ? Oui, en le marquant comme non répertorié. Et c'est le piège de la rubrique : la page produit de Shopify précise que cette option "masque aussi le produit des sitemaps, des moteurs de recherche comme Google, et de la recherche de votre boutique en ligne". Retirer un article des assistants IA le retire donc également de Google, ce qui en fait un arbitrage commercial et non un réglage technique.
- Shopify Now Enrolls Your Store In Every New AI Shopping Channel Source : Search Engine Journal
- Shopify Extends WebMCP Into Checkout For Browser Agents Source : Search Engine Journal
- Google rolls out Merchant Center UCP integration hub in the U.S. Source : Search Engine Land
Vos flux RSS redeviennent utiles : les robots d’IA les ouvrent
Dans l'épisode du 1er octobre de Search Off the Record, consacré à l'utilité des sitemaps, John Mueller et Martin Splitt ont abordé la découverte des contenus par les systèmes d'IA. Un sitemap peut être rendu difficile à trouver, avec un nom de fichier inhabituel et une absence de mention dans le robots.txt, puis soumis directement à Google. Mais il devient alors invisible pour tout système à qui on ne l'a pas soumis, et les robots d'entraînement des IA n'offrent en général aucune console de soumission. Mueller recommande donc deux portes pour qui veut être trouvé par eux : le nom générique sitemap.xml, ou un flux RSS, plus facile à repérer parce qu'il est habituellement lié depuis l'en-tête de la page. Il indique voir dans ses propres journaux de serveur des robots d'IA accéder à son sitemap et à ses fichiers RSS.
Faut-il en conclure qu'un flux RSS fait citer son contenu ? Non, et Mueller ne le dit pas : il constate l'accès et précise ne pas savoir ce que ces robots font du fichier. Ce qui est établi, c'est que le flux est une porte qu'ils trouvent seuls et qu'ils poussent. Cela compte d'autant plus que ces mêmes collecteurs n'exécutent pas le JavaScript, comme nous l'écrivions la semaine dernière : sur un site dont le contenu se construit dans le navigateur, le flux peut être la seule chose complète qu'ils sachent lire.
Les sitemaps eux-mêmes ont-ils changé ? Les deux champs qui annoncent l'importance d'une page et sa fréquence de mise à jour, priority et changefreq, sont ignorés, parce que trop de sites plaçaient la priorité maximale partout. Le champ qui porte la date de dernière modification, lastmod, reste pris en compte tant que ses valeurs paraissent cohérentes : un générateur qui écrit la date du jour sur toutes les URL peut faire cesser son usage par Google, et Mueller précise que ce n'est pas une sanction anti-spam. Le sitemap doit porter les versions canoniques, sans paramètres de suivi, cette présence étant l'un des signaux de choix de la canonique.
Une erreur "Impossible de récupérer" est-elle un problème technique ? Pas forcément, et c'est le renversement de diagnostic de la semaine. Mueller cite trois causes et une seule est technique : la charge du serveur. Les deux autres relèvent de la demande d'exploration, qu'il rattache sans détour à la qualité perçue du site. Il le dit ainsi : "la demande d'exploration est très souvent fondée sur la qualité perçue d'un site, et cela peut avoir un impact vraiment important sur ce que nous explorons et indexons depuis un site. Ce n'est donc pas purement une question technique." Sur un sitemap valide et accessible, le symptôme devient un signal éditorial, et aucune correction d'infrastructure ne le lèvera.
- Google's Mueller Says AI Crawlers Access Sitemaps & RSS In His Logs Source : Search Engine Journal
- Les sitemaps sont-ils encore utiles ? Google répond Source : Position Zéro
- Google Explains The "Couldn't Fetch" Sitemap Errors Source : Search Engine Journal
La Search Console compare enfin plusieurs pays dans un seul rapport
Le rapport de performances de la Search Console permet désormais de sélectionner plusieurs pays simultanément, là où le filtre n'en acceptait qu'un.

Qui y gagne du temps ? Toute personne qui suit un site visant plusieurs marchés. Jusqu'ici, comparer trois pays imposait trois exports recollés à la main, avec les erreurs de recollage que cela suppose.
Qu'est-ce que ça permet de voir qu'on ne voyait pas ? La comparaison elle-même. Un écart de taux de clic entre deux marchés sur les mêmes requêtes se lit immédiatement, alors qu'il se perdait dans la moyenne d'un rapport global ou dans la juxtaposition de deux fichiers.
[VISUEL : visuels-2026-10-07/gsc-filtre-multipays-anonymise.png | Le filtre de pays accepte maintenant plusieurs valeurs : la puce affiche "Pays : France + 2". | alt : Barre de filtres du rapport de performances de la Search Console, avec une puce de filtre indiquant Pays France plus deux autres pays.]
- Google Search Console Lets You Filter By Multiple Countries Source : Search Engine Journal
- Google Search Console performance report filter allows selection of multiple countries Source : Search Engine Land
- Google Search Console Performance Report Multi-Select Country Filters Source : Search Engine Roundtable
Votre seul chiffre d’abonnés Google n’existe que dans un mail
Google envoie désormais par mail aux propriétaires de sites le nombre de personnes qui les ont désignés comme source préférée dans leurs résultats de recherche.
Pourquoi ce chiffre compte-t-il plus qu'il n'y paraît ? Parce qu'il mesure une démarche volontaire. C'est le nombre de gens qui ont pris la peine de déclarer vouloir voir un site en priorité, soit l'équivalent le plus proche d'un abonnement à l'intérieur de Google, et il n'existe aucune autre mesure de cette population.
Où le retrouver plus tard ? Nulle part. Aucun tableau de bord ne reprend cette donnée, qui n'est donc pas historisée : un mail classé dans les promotions est une mesure perdue.
Que faire en pratique ? Sortir l'expéditeur des promotions et relever le chiffre à chaque envoi dans un fichier ou une ligne de tableau de bord. La valeur de cette donnée est dans sa série, et la série ne se reconstitue pas.
- Google shares preferred source follower data via email Source : Search Engine Land
- Google Email Shares Number Of Preferred Source Subscribers Source : Search Engine Roundtable
OpenAI vend de la publicité dans la génération d’images de ChatGPT
OpenAI a annoncé sur son blog un format publicitaire visuel dans ChatGPT. Les annonces montrent des services et des produits par l'image, apparaissent pendant le processus de génération d'images, sont clairement étiquetées et tenues distinctes des images que ChatGPT produit pour l'utilisateur. L'entreprise écrit que ce format "aide les gens à imaginer comment des produits et services pourraient s'intégrer à leur vie", et précise que "comme pour nos autres formats publicitaires, la publicité n'influence pas les réponses que ChatGPT fournit". OpenAI annonce que les tests commenceront "plus tard ce mois-ci" aux États-Unis, avec un groupe initial d'annonceurs. OpenAI indique par ailleurs avoir étendu ses outils de mesure publicitaire et ses partenariats annonceurs.
Qu'est-ce que ce format change par rapport aux annonces textuelles ? Il ouvre un inventaire là où il n'y en avait pas. La publicité entre dans ChatGPT par l'image et non par le texte de la réponse, dans un moment où l'utilisateur attend précisément de voir quelque chose. Pour un annonceur, c'est une surface neuve et sans concurrence installée.
Combien ça coûte et comment c'est facturé ? OpenAI ne l'a pas publié. L'annonce ne donne ni modèle de facturation, ni prix de départ, ni critères de sélection des annonceurs du groupe initial. Un plan média sur ce format est donc impossible à chiffrer à ce stade, et toute estimation circulant sur le sujet n'a pas de source.
Faut-il s'y préparer dès maintenant ? Le test est américain et limité, donc il n'appelle aucune action immédiate hors des États-Unis. Le signal à suivre est l'extension géographique et l'ouverture en libre-service : c'est à ce moment que la question du budget se posera, et non avant.
- OpenAI tests new visual ad format in ChatGPT Source : Search Engine Watch
- OpenAI To Test Visual ChatGPT Ad Format During AI Image Generation Source : Search Engine Roundtable
- OpenAI Testing New Product Labels On ChatGPT Results Source : Search Engine Roundtable
Les chiffres-clés à retenir
- 82,91 % : part des recherches de marque sur ordinateur aux États-Unis qui affichent un aperçu IA au 29 septembre, contre 65,1 % en août (Ahrefs, 232,8 millions de recherches analysées).
- 24,2 % contre 23,9 % : part des réponses d'IA qui recommandent une marque, selon qu'elle n'a aucun balisage ou qu'elle en empile six types, contre 11,2 points pour la clarté de l'offre (First Page Sage, 4 213 requêtes commerciales, 1 089 marques).
- 0 sur 12 : nombre de recommandations reçues à l'achat par une marque citée dans 97,5 % des réponses de découverte (Foundation, 252 réponses).
- 51,1 % : part de la présence des sources captée par les listicles sur les questions de catégorie, contre 12,6 % pour les pages de comparaison dédiées (Foundation, 2 695 présences relevées).
- 48,6 % : part des aperçus IA français livrés après la page, par une requête secondaire (Monitorank, 2 millions de SERP, collecte du 9 au 14 septembre).
- 30 % : recouvrement maximal entre un relevé d'interface et un relevé par accès développeur sur les mêmes requêtes (Surfer, 13 779 réponses).
- 92 % à 17 % : chute du taux de détection du filigrane d'OpenAI quand un mot sur quatre est remplacé par un synonyme, sur des passages de 400 jetons (OpenAI).
- 69 % : part des professionnels déclarant publier une part plus grande de contenu IA qu'il y a un an (Ahrefs, 301 répondants).
- 3 à 6 mois : délai de reprise après une core update annoncé par Google à Barcelone (compte rendu ROAST).
- 7 jours : délai annoncé par Shopify avant que les données produit cessent d'être partagées après coupure de l'accès au catalogue (documentation Shopify).
Retrouvez aussi mes dernières publications sur le LinkedIn de @Plume Numérique et de @Sandrine Lasserre
Les articles publiés cette semaine sur le blog de Plume Numérique
Retrouvez la revue de presse de la semaine précédente
Revue du digital – semaine du 28 septembre 2026

0 commentaire