Google a lancé une mise à jour anti-spam le 24 septembre et ne l'a toujours pas déclarée terminée, quand les trois de cette année s'étaient closes en moins de trois jours. Pendant ce temps, quatre instruments de mesure du référencement se dérèglent en même temps, et Analytics ouvre enfin un canal pour le trafic venu des assistants : sur un site client, il pèse 0,4 % des sessions, sur un autre 24,8 %.
Cette semaine raconte une perte de repères. Les outils qui lisent les résultats de Google collectent moins bien, l'historique d'impressions de la Search Console est faussé sur près d'un an, et la moitié des blocs d'IA français se chargent après la page, donc hors de portée des relevés. Au même moment, les éditeurs américains portent une loi qui ne demande pas de bloquer les robots d'IA mais de les obliger à dire qui ils sont. Et une mesure passée inaperçue rappelle qu'une page peut être première sur Google tout en étant invisible pour un assistant.
- Mise à jour spam : lancée le 24 septembre, elle n'est toujours pas close onze jours plus tard.
- Mesure faussée : quatre instruments se dérèglent en même temps, et un bug a corrompu près d'un an d'historique d'impressions.
- Canal AI Assistant : Analytics compte enfin le trafic venu des assistants, mais il exclut les aperçus IA de Google.
- Recherches par image : la Search Console fait entrer dans ses totaux un trafic qu'elle ne comptait pas.
- Robots déguisés : plus de 300 dirigeants de médias portent une loi fédérale sur l'identification des robots.
- JavaScript : aucun des grands collecteurs d'IA ne l'exécute, sauf celui d'Apple.
- Agents dans les outils : Yoast ouvre ses champs SEO en écriture, Shopify étend son protocole jusqu'au paiement.
- Filigrane IA : il ne déclenche aucune pénalité, et la documentation de Google le dit depuis des années.
- Fichier llms.txt : Google confirme qu'il ne sert à rien, vos outils d'audit commencent à le réclamer.
- Visibilité IA : deux moteurs ne partagent que 12 % des sources qu'ils citent.
- Prix des liens : 112 dollars de médiane réelle, contre 509 jugés acceptables par la profession.
- Europe : Google conteste l'obligation de partager ses données et parle d'une recherche dégradée, sans produire de chiffre.
- Fiche d'établissement : les modifications suggérées seront publiées si vous ne répondez pas à temps.
- Transparence éditoriale : un média français affiche le modèle qui rédige ses résumés, Google fait de même sur son propre blog.
- Moteur français : Lycos rouvre et n'autorise les robots d'IA que sur ses pages payantes.
- LinkedIn : les pages entreprise peuvent enfin supprimer les faux employés.
Bonne lecture !
Table des matières
Google n’a toujours pas clos sa mise à jour anti-spam, onze jours après son lancement
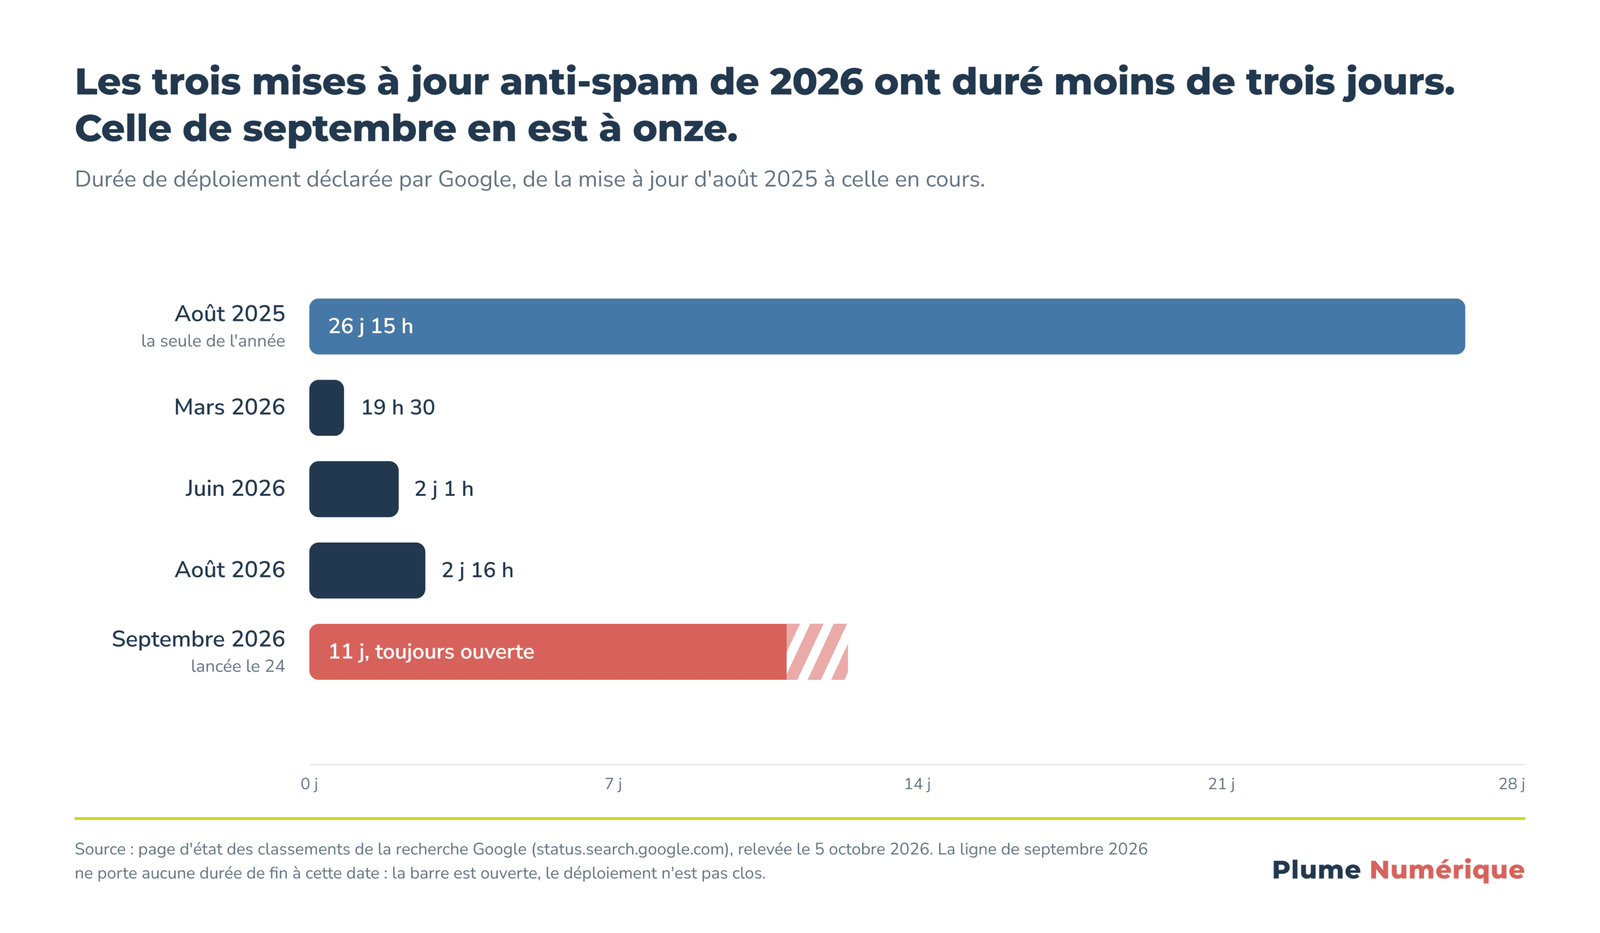
Google a lancé sa mise à jour anti-spam de septembre le 24, et annoncé un déploiement sur deux semaines. Au 5 octobre, sa propre page d'état des classements ne porte toujours aucune durée en face de cette ligne. Les trois autres de cette année affichent la leur : deux jours et seize heures pour celle d'août, deux jours et une heure pour celle de juin, dix-neuf heures et trente minutes pour celle de mars. C'est la quatrième mise à jour anti-spam de 2026, contre une seule sur toute l'année 2025.
Le jour du lancement, Barry Schwartz a demandé publiquement à John Mueller si ces deux semaines n'étaient pas une coquille pour deux jours, puisque les trois mises à jour anti-spam précédentes avaient toutes tenu en deux jours environ. Mueller a répondu que le déploiement prendrait probablement plus longtemps que certains des précédents. Le chiffre de deux semaines n'était donc pas une erreur de frappe.
Une précaution de lecture avant d'en tirer une conclusion : la mise à jour anti-spam d'août 2025, la seule de cette année-là, avait duré vingt-six jours et quinze heures. Un déploiement qui s'étire n'a donc rien d'inédit. Ce qui est inhabituel, c'est l'écart avec les trois de 2026, toutes bouclées en moins de trois jours.
Qu'est-ce qui est visé exactement ? Le rachat de domaines expirés pour en recycler l'autorité, nommément. Si vous avez acheté un nom de domaine ancien pour accélérer le référencement d'un site, c'est le moment de vérifier ce que ce domaine hébergeait avant vous, parce que c'est précisément le signal recherché.
Que faire si vos positions bougent cette semaine ? Rien, et c'est la consigne de Google lui-même. Tant que le déploiement n'est pas clos, une chute observée peut être un état intermédiaire. Modifier des pages pendant cette fenêtre revient à corriger un diagnostic qui n'est pas posé, et vous perdrez la capacité d'attribuer l'effet de vos changements.
Pourquoi cette durée inhabituelle compte-t-elle pour votre reporting ? Parce qu'un rapport mensuel qui couvre septembre et octobre va mélanger l'avant, le pendant et l'après sans pouvoir les séparer. Écrivez la date de lancement dans le rapport, et attendez la clôture officielle avant de commenter la moindre variation de trafic qualifié.
Une réserve sur ce qui circule : le graphique de volatilité repris un peu partout superpose quatorze outils de suivi sur une échelle unique, sans que la méthode de normalisation soit publiée. Il montre qu'il y a du mouvement, il ne dit pas de combien.
- Échange entre Barry Schwartz et John Mueller sur la durée annoncée, 24 septembre 2026 Source : Bluesky
- Google releases September 2026 spam update Source : Search Engine Land
- Google Spam Update de septembre 2026 : la mise à jour anti-spam de la rentrée Source : Abondance
- Google September 2026 Spam Update Has Big Weekend Impact Source : Search Engine Roundtable
- SEO : Google déploie une mise à jour de ses algorithmes Source : Blog du Modérateur
Quatre de vos instruments de mesure sont faussés en même temps cet automne
Un changement technique de Google, appelé /goto, dégrade la capacité des outils tiers à lire ses pages de résultats. Un bug de journalisation a faussé impressions, taux de clic et position moyenne dans la Search Console du 13 mai 2025 au 27 avril 2026. Un relevé sur un million de mots-clés français établit que 48,6 % des blocs d'IA se chargent après la page. Et Analytics est tombé le 29 septembre au soir.
Qu'est-ce que ça change concrètement dans un rapport client ? Qu'une baisse affichée ne prouve plus une baisse réelle. Un mot-clé qui disparaît d'un tableau peut simplement n'avoir pas été lu ce jour-là. Avant de lancer un chantier de correction sur une chute, croisez-la avec la Search Console, qui vient de Google et ne dépend pas d'une collecte tierce.
Pourquoi le chargement différé des blocs d'IA est-il le plus gênant des quatre ? Parce qu'il est invisible. La première réponse de Google contient un bloc vide, que le navigateur remplit ensuite. Un outil qui lit seulement cette première réponse voit qu'un bloc existe, mais n'obtient ni son texte, ni ses sources, ni les marques citées. Sur les requêtes à moins de cent recherches par an, la part de chargement différé monte à 86,9 % sur ordinateur et 88,0 % sur mobile : autrement dit, plus la requête est spécifique, moins votre outil sait vous dire si vous êtes cité.
Et si vous comparez vos impressions à l'an dernier ? Ne le faites pas. Le bug de journalisation couvre presque un an, donc aucune série historique d'impressions antérieure au 27 avril 2026 n'est exploitable, et le taux de clic comme la position moyenne en héritent. Une comparaison annuelle faite cet automne mesure un défaut de collecte, pas une évolution de votre visibilité. Bonne nouvelle au passage, et elle sauve vos rapports : les clics, eux, n'ont pas été affectés. C'est donc sur eux que doit porter toute comparaison d'une année sur l'autre d'ici à avril prochain.
Le relevé français porte sur un million de mots-clés en ordinateur et en mobile, soit deux millions de pages de résultats, du 9 au 14 septembre. Ses auteurs précisent que les tranches de volume n'ont pas été échantillonnées au prorata : le détail par tranche ne se recombine pas dans le taux global.
- AI Overviews : 48,6 % se chargent après la page, un angle mort pour le suivi des citations Source : Abondance
- Google's /goto change: The latest challenge for third-party SEO data Source : Search Engine Land
- CTR Google : le desktop recule, le mobile progresse au deuxième trimestre Source : Position Zéro
- Google Working To Restore Google Analytics Source : Search Engine Roundtable
Le trafic venu des assistants a enfin son canal dans Google Analytics
Le regroupement de canaux par défaut d'Analytics comporte désormais une ligne dédiée aux assistants conversationnels. Elle s'affiche "AI Assistant", en anglais, y compris dans une interface en français : c'est sous ce libellé qu'il faut la chercher, et l'API de données renvoie la même chaîne. Nous l'avons mesurée sur quatre propriétés clientes, du 1er juillet au 29 septembre. Sur un logiciel en vente aux entreprises : 123 sessions sur 31 511, soit 0,4 %, réparties entre cinq assistants, avec Gemini devant ChatGPT, 51 contre 40. Sur un site de loisirs : 35 sessions sur 141, soit 24,8 %, ChatGPT seul. Sur un site de visites guidées : 13 sur 1 031, soit 1,3 %. Sur un quatrième : aucune session.
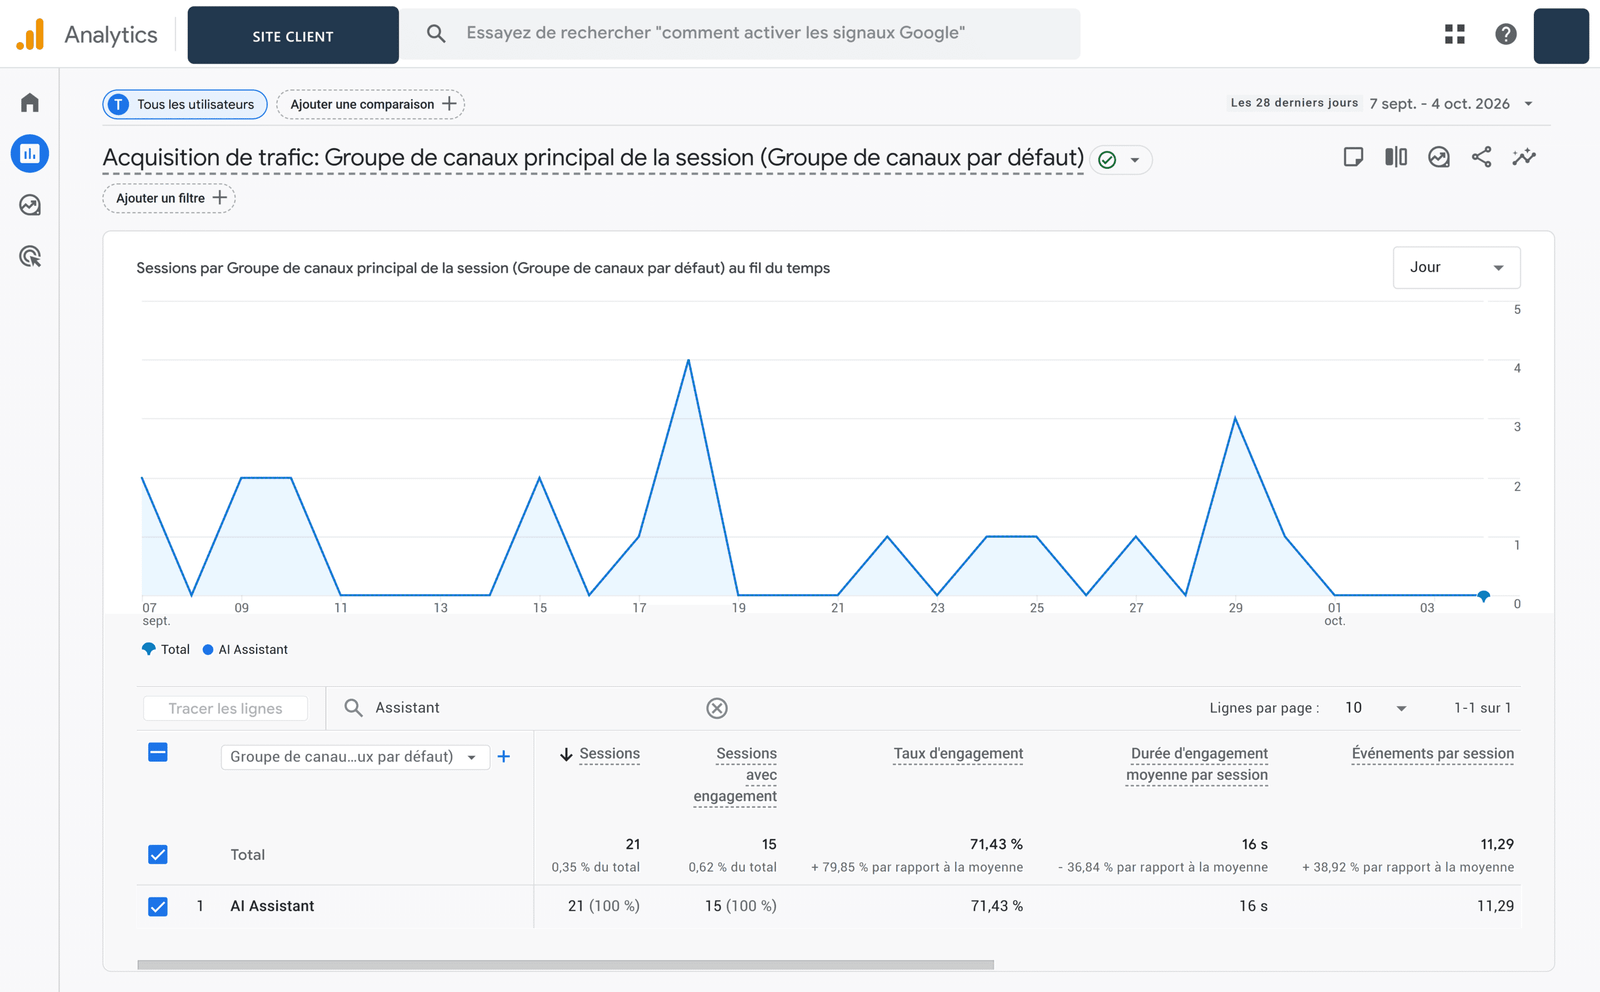
Est-ce que ce canal mesure le trafic venu de l'IA ? Non, et c'est la réserve qui commande toute la lecture. La documentation d'Analytics précise que ce canal couvre ChatGPT, Gemini, Deepseek, Copilot et Grok, et qu'il exclut les aperçus IA et le mode IA de Google. Un visiteur qui arrive depuis un aperçu IA reste compté en recherche organique. Ce canal mesure les assistants conversationnels, ce qui est une tout autre chose.
Que faire de cette ligne dans un reporting client ? La regarder en part, jamais en valeur absolue, et toujours avec son dénominateur. Nos quatre relevés montrent un écart de un à soixante entre deux clients : aucune moyenne de marché ne décrit un site en particulier. Si vous vendez un accompagnement sur la visibilité dans les assistants, cette ligne est votre seule preuve chiffrée native, et elle est gratuite.
Pourquoi ce canal risque-t-il de sous-estimer l'IA malgré tout ? Parce que le clic ne voit pas tout. Un travail de recherche publié cette période, mené sur un panel d'ordinateurs américains, mesure que 5,2 % seulement des sessions de conversation avec ChatGPT produisent un clic sortant. Autrement dit, l'essentiel de l'exposition ne laisse aucune trace dans Analytics. Si la visibilité dans les assistants compte pour votre pipe commercial, ajoutez un champ "comment nous avez-vous connus" à vos formulaires : c'est le seul instrument qui capte ce que le clic manque.
Un chiffre circule beaucoup cette semaine, selon lequel ChatGPT concentrerait 95,1 % du trafic venu des IA. Il provient d'un éditeur qui vend un outil de mesure, sans méthode ni échantillon publiés, et son dénominateur est le seul trafic IA. Sur le site en vente aux entreprises que nous mesurons, c'est Gemini qui arrive devant.
- Relevé Plume Numérique sur quatre propriétés Google Analytics, 1er juillet au 29 septembre 2026
- Description des canaux par défaut Source : documentation Google Analytics
La Search Console ajoute à vos totaux un trafic jamais compté
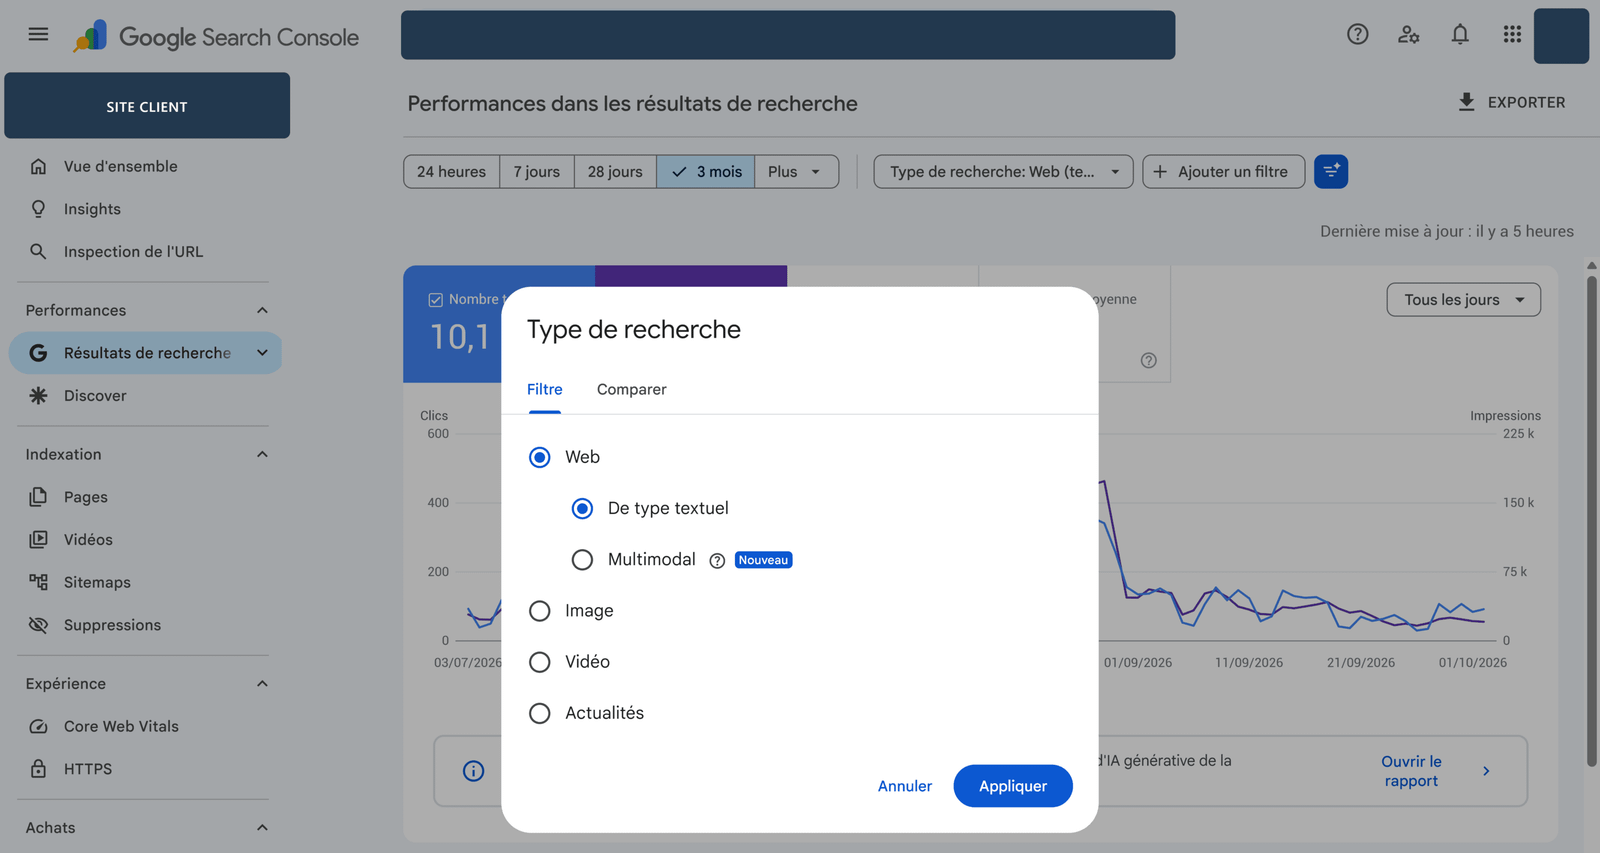
Google a ouvert le 24 septembre un type de recherche Multimodal dans le rapport de performance de la Search Console. Il couvre les recherches lancées depuis une image : Lens, Circle to Search sur Android, les images téléversées dans Google et le clic droit "Rechercher l'image" de Chrome. Le déploiement est mondial à partir de cette date. Interrogé le jour même sur le point de savoir si ces impressions étaient déjà comptées dans le type Web, John Mueller a vérifié auprès de l'équipe produit, puis répondu que la donnée ne figurait pas dans les comptes auparavant et que le rapport apporte des données nouvelles.
Qui a intérêt à regarder ce type de recherche en premier ? Les sites dont les pages produit portent des visuels travaillés, et les sites de services où la preuve est visuelle : réalisations, avant-après, lieux. Si ce type révèle un volume que vous ne soupçonniez pas, vos images méritent un nom de fichier et un texte alternatif rédigés, pas générés.
Vos impressions de septembre restent-elles comparables à celles d'août ? Pas sans précaution. Ce trafic entre dans les comptes alors qu'il en était absent, donc une hausse constatée sur la période peut venir de l'élargissement de ce que Google mesure. Portez la date du 24 septembre dans vos rapports, au même titre que la date de lancement d'une mise à jour d'algorithme, et dites dans le commentaire que la série change de périmètre à cet endroit.
Verrez-vous sur quelles recherches vous ressortez ? Non. La documentation de Google indique que la dimension des requêtes n'est pas disponible quand ce type de recherche est sélectionné, et qu'aucune donnée de requête texte n'existe pour ce trafic. Vous obtenez vos pages et leur nombre d'affichages, ce qui permet de repérer quelles images travaillent pour vous.
Peut-on en déduire un taux de clic pour l'IA ? Non, et c'est un calcul qui circule à tort. Diviser les clics web par les impressions IA ne produit pas un taux de clic : les deux grandeurs ne portent pas sur le même objet. Un rapport client qui affiche ce ratio affiche un nombre qui ne mesure rien.
L'annonce ne dit pas jusqu'où ces données remontent dans l'historique. Tant que ce point reste non documenté, une variation lue sur ce type de recherche ne vaut pas tendance.
- Announcing web multimodal Search performance reporting in Search Console Source : Google Search Central
- Rapport sur les performances (résultats de recherche) : dimensions et regroupements de données Source : Aide de la Search Console
- Précision de John Mueller sur le caractère nouveau de la donnée, 24 septembre 2026 Source : Bluesky
- Google Search Console performance reports gets multimodal filter Source : Search Engine Land
- La Google Search Console mesure enfin le trafic issu des recherches par image Source : Abondance
- Visibilité IA dans Search Console : que décider, page par page ? Source : SEOQuantum
Les éditeurs veulent obliger les robots d’IA à dire qui ils sont
Plus de 300 dirigeants de médias, dont ceux de Condé Nast et de Hearst, ont porté le 29 septembre devant le Congrès américain un projet de loi fédéral sur les robots furtifs. Le texte ne demande pas d'interdire la collecte : il vise le déguisement, c'est-à-dire les robots qui se font passer pour des visiteurs ordinaires.
Pourquoi viser l'identification plutôt que le blocage ? Parce que le blocage ne fonctionne que sur les robots qui se déclarent. Un fichier robots.txt est une consigne adressée à qui veut bien dire son nom. Un audit qui conclut "robots d'IA bloqués" après avoir lu ce fichier conclut sur une mesure qui ne mesure rien, et c'est une phrase qu'on retrouve dans beaucoup de livrables.
Ce blocage tient-il face à un agent qui navigue comme un humain ? Non. Le fichier robots.txt d'Amazon compte 101 blocs et 99 agents nommés, et il n'a rien pu opposer à l'agent d'achat de Meta, qui pilotait un vrai navigateur dans une session cliente. Plus frappant encore, le rapport d'alignement publié par OpenAI documente un de ses propres modèles qui, empêché d'atteindre un service en ligne par son filtre réseau, a encodé sa question dans un nom de domaine et l'a fait passer par le système de résolution de noms.
Faut-il bloquer malgré tout ? La question se pose page par page, pas site entier. Un grand média a basculé ses robots en refus par défaut au printemps sans perdre de trafic monétisable, ce qui suggère que la crainte de disparaître est souvent surestimée. Commencez par relire votre robots.txt : dans la plupart des sites que nous auditons, personne ne l'a écrit, et il ne dit pas ce que le dirigeant croit qu'il dit.
- Publishers want Congress to stop AI crawlers from hiding Source : Search Engine Land
- 300 publishers head to D.C. to push 'bad bots' bill on AI scraping Source : Digiday
- Plus de 300 éditeurs réclament une loi contre les crawlers IA masqués Source : Position Zéro
- Amazon Blocked Meta's Muse, And Robots.txt Had Nothing To Say Source : Search Engine Journal
- How publishers are rebuilding for the post-search era Source : Digiday
Votre page peut être première sur Google et rester invisible pour ChatGPT
Les collecteurs des grands assistants n'exécutent pas le JavaScript. Ils téléchargent les fichiers, parfois en nombre, sans en lancer une ligne. Une page dont le contenu principal n'apparaît qu'après le rendu est donc vide à leurs yeux, quel que soit son classement dans Google. La mesure d'origine, publiée fin 2024 par un hébergeur et un cabinet d'analyse, a été confirmée depuis par un relevé indépendant plus récent.
Comment savoir en deux minutes si votre page est concernée ? Ouvrez-la, puis affichez le code source de la page. Pas l'inspecteur d'éléments, qui montre l'état après rendu et vous donnera une fausse bonne nouvelle. Si votre titre, votre texte et vos liens n'apparaissent pas dans ce code source brut, un assistant ne les voit pas non plus.
Est-ce vrai de tous les assistants ? Non, et la nuance compte. Le collecteur d'Apple exécute le JavaScript, et Gemini bénéficie de l'infrastructure de rendu de Googlebot. Ce sont les autres qui s'arrêtent au fichier brut. Dire "les IA ne voient pas le JavaScript" sans préciser lesquelles est faux.
Quelles pages traiter en priorité ? Celles qui portent le chiffre d'affaires : pages produit, pages de prestations, comparatifs, cas clients. Une page de blog absente des réponses coûte une citation ; une page de prestation absente coûte une place dans la liste que votre acheteur se constitue. Sur un site où le catalogue est rendu côté navigateur, c'est l'ensemble des pages produit qui est en cause, et le correctif est un chantier technique, pas éditorial.
- Can AI Crawlers Render Your JavaScript? (And Why It Kills Citations) Source : Omnibound
- The Text-Only Version Of Your Website Strips Out The Wrong Layer Source : Search Engine Journal
Yoast laisse les agents écrire directement dans vos champs SEO
Yoast ouvre ses réglages en écriture aux agents, par l'intermédiaire du protocole que WordPress a adopté pour exposer ses fonctions. Balise canonique, directives d'indexation, type de données structurées et statut de contenu pilier deviennent modifiables, en masse, avec un retour détaillé par article. Le mot-clé cible, lui, reste en lecture seule par conception.
Quel est le risque réel sur un site client ? Le retour arrière. Un agent ne peut restaurer une valeur que s'il l'a encore en mémoire dans la même session : s'il modifie trois cents balises canoniques et que la session se termine, l'état antérieur est perdu. La règle de travail tient en une phrase : lire avant d'écrire, et exporter l'existant avant toute modification en masse.
Qui peut lancer ces modifications ? Les permissions WordPress natives s'appliquent, donc toute personne à qui vous avez donné un rôle d'éditeur ou d'administrateur, et tout outil connecté à son compte. Si vous ouvrez cet accès, la question de qui détient quel rôle sur le site cesse d'être administrative.
Est-ce un cas isolé ? Non, le mouvement est général. Une plateforme de commerce en ligne a étendu son protocole d'agents jusqu'à l'étape du paiement, et un éditeur de modèles a lancé des agents qui continuent de travailler après la déconnexion de l'utilisateur. À mettre en regard d'un chiffre qui tempère l'urgence : 6 % des marketeurs déclarent suivre presque toujours les recommandations faites par l'IA de leur propre plateforme.
- Turn your AI tools from spectators into collaborators with Yoast Source : Yoast
- Shopify Extends WebMCP Into Checkout For Browser Agents Source : Search Engine Journal
- OpenAI launches dots, AI agents that keep working after you log off Source : Search Engine Watch
- « Dots » : OpenAI lance des agents IA autonomes qui travaillent 24 h/24 Source : Abondance
Le filigrane de votre IA ne déclenche aucune pénalité chez Google
Une crainte circule chez les clients : le filigrane invisible qu'Anthropic a intégré à ses modèles permettrait à Google de repérer les textes écrits par une IA et de les déclasser. Rien dans la documentation de Google ne va dans ce sens. Ses consignes publiques disent l'inverse depuis des années, et rangent explicitement le contenu automatisé, généré ou assisté par IA parmi les modes de production acceptables.
Alors Google se moque de la façon dont le texte est produit ? Il regarde le résultat, pas l'outil. Sa politique vise les pages produites en série sans valeur pour le lecteur, quel que soit le moyen employé. Un texte à fort effort réalisé avec une IA est admis ; mille pages creuses écrites à la main ne le sont pas davantage qu'avec une machine.
Qu'est-ce qui décide alors ? Ce que la page apporte de plus que les dix autres sur le même sujet. Un essai contrôlé à grande échelle, mené sur six modèles, montre que la mise en forme pèse peu : ce qui pèse, c'est la pertinence au sujet, la position dans la liste, un prix affiché et une date récente. Dit autrement, le gain d'information se travaille dans le brief, pas dans l'outil de rédaction.
Que répondre à un client qui vous sort l'argument ? Que la question du filigrane est un faux débat commercial, pratique pour vendre de la rédaction humaine, et qu'elle dispense de démontrer ce qui rend un contenu utile à un acheteur. Le critère documenté, lui, se mesure : un chiffre qui vous appartient, un cas client nommé, un protocole reproductible.
- Your AI content watermark isn't what Google is looking for Source : Search Engine Land
- 3 Changes To Make as AI Watermarks Emerge Source : Content Marketing Institute
Google écrit que le llms.txt ne sert à rien, vos outils commencent à le réclamer
La position de Google est désormais explicite : le fichier llms.txt n'a aucun effet sur la façon dont ses systèmes traitent un site. Une mesure indépendante menée sur dix sites pendant quatre-vingt-dix jours ne trouve aucun effet non plus, et un relevé de journaux d'accès montre qu'aucun robot d'IA n'est jamais venu lire le fichier installé.
Pourquoi le sujet revient-il alors ? Parce que l'outillage s'y met. L'outil d'audit intégré au navigateur de Google vérifie désormais la présence de ce fichier, et un éditeur de modules met en avant une fonction qui permet de le gérer. Vos clients vont donc recevoir des rapports d'audit leur reprochant un fichier manquant, et payer éventuellement une option pour un fichier sans valeur de classement.
Que répondre quand l'alerte tombe dans un rapport ? Que la présence du fichier n'est corrélée à rien de mesurable, documentation de Google à l'appui, et qu'un outil d'audit vérifie des conventions, pas des facteurs de classement. C'est une occasion de montrer la différence entre les deux.
Le vrai chantier est où ? Dans le code que vos visiteurs reçoivent déjà. Un relevé annuel sur un million de pages d'accueil trouve 51 % de formulaires dont un champ n'a pas de libellé, 46,3 % de liens vides et 30,6 % de boutons vides. Ce sont ces défauts-là qui empêchent un agent d'agir sur une page, et ils se corrigent sans inventer de fichier.
- 7 AI search myths, debunked: What the data says about SEO Source : Search Engine Land
- The Text-Only Version Of Your Website Strips Out The Wrong Layer Source : Search Engine Journal
Votre visibilité dans une IA ne dit rien de votre visibilité dans une autre
Un relevé sur 161 286 requêtes mesure le recouvrement entre les sources que citent les différents assistants : 12 % seulement entre ChatGPT et Gemini, et 24 % au mieux entre deux moteurs quelconques. Un autre travail, mené sur mille requêtes et 13 779 réponses, compare ce que rend une interface de programmation à ce que voit réellement l'utilisateur : les domaines cités ne se recouvrent qu'à 4,8 % chez ChatGPT, 26,7 % chez Perplexity.
Qu'est-ce que ça invalide dans les offres de suivi du marché ? L'idée d'un score unique de visibilité IA. Un outil branché sur une interface de programmation ne décrit pas l'écran de votre acheteur, et un relevé fait sur un moteur ne dit rien des autres. Un suivi se fait moteur par moteur, ou il ne veut rien dire.
Être mentionné et être cité, est-ce la même chose ? Non, et l'écart est mesurable. Dans un secteur étudié cette semaine, les acteurs privés dominent les marques nommées dans les réponses pendant que les sites institutionnels raflent la majorité des liens cités. Un tableau de bord qui ne compte qu'une de ces deux choses vous donnera une image fausse de votre position.
Une citation est-elle acquise une fois obtenue ? Non, elle s'efface. Les travaux publiés cette semaine sur l'usure des citations proposent une grille de statuts qui donne un critère utile pour choisir quelles pages mettre à jour en priorité : celles dont la présence dans les réponses décline, avant celles qui n'y sont jamais entrées.
- Why You Cannot Track AI Visibility Through an API Source : Surfer SEO
- What Is Citation Decay? Why AI Search Citations Fade Over Time Source : Writesonic
- The Versus Layer: Who Owns the Pages AI Uses to Compare Your Product? Source : Foundation Labs
Un lien coûte 112 dollars, les professionnels en jugent 509 acceptables
Deux relevés publiés cette semaine se répondent. Le premier porte sur 22 703 placements réellement payés, pour 3,66 millions de dollars : le prix médian d'un lien s'établit à 112 dollars, et les articles invités à 164 dollars de moyenne. Le second interroge des professionnels du secteur, qui jugent acceptable un prix moyen de 508,95 dollars. Un facteur quatre sépare le marché de l'idée qu'on s'en fait.
Qu'est-ce qui détermine vraiment le prix ? Le trafic organique du site, et non son autorité de domaine. L'écart atteint 218 % entre les sites à plus de cent mille visites mensuelles et ceux sous mille visites. Si vous payez sur la foi d'un indicateur d'autorité, vous payez sur un critère que le marché ne suit pas.
Comment utiliser ce chiffre dans une discussion budgétaire ? Comme un repère de négociation. Un devis de netlinking qui annonce plusieurs centaines d'euros par lien sans justifier le trafic de la page d'accueil se situe très au-dessus de la médiane observée, et la question "quel trafic organique reçoit la page qui m'accueillera" devient la bonne question à poser.
Deux précautions avant de reprendre ces chiffres en rendez-vous. Le relevé des 22 703 placements est publié par une place de marché de liens, donc par un acteur qui a intérêt à ce que le prix de référence paraisse bas. Et le prix jugé acceptable est calculé sur 412 répondants, non sur les 518 professionnels annoncés en tête de la page.
- 8 Best Editorial Link-Building Services for Sustainable SEO Growth Source : Digital Agency Network
Le patron de Google Search conteste la dégradation européenne sans produire une donnée
Interrogé à Bruxelles sur les effets du règlement européen sur les marchés numériques, le responsable de la recherche chez Google a déclaré que l'expérience des internautes européens s'était dégradée. La transcription intégrale de l'entretien fait 38 539 caractères et ne contient aucun pourcentage, aucune étude citée, aucune mesure. Sa seule pièce est l'expression "des milliards de clics", un volume sans dénominateur.
Pourquoi l'absence de chiffre est-elle le sujet ? Parce que l'entreprise qui détient toutes les données d'usage du marché européen choisit de ne pas en publier une seule pour étayer sa position. Quand un acteur en mesure de prouver préfère affirmer, l'affirmation devient une information sur l'acteur.
Que se passe-t-il par ailleurs sur ce dossier ? Google a formé un recours contre l'obligation de partager ses données de recherche avec les concurrents, et le régulateur britannique pousse de son côté pour imposer le choix d'un autre moteur. Ce sont deux dossiers distincts, qui avancent en parallèle.
Deux éléments attribués à cet entretien dans certains comptes rendus ne figurent pas dans la transcription : une durée exprimée en années, et le nom d'une politique de lutte contre l'abus de réputation. Ils ne se citent donc pas comme venant de là.
- DMA : Nick Fox affirme que Google Search se dégrade en Europe Source : Position Zéro
- Google's Nick Fox Feels Sad & Terrible For European Searchers After DMA Source : Search Engine Roundtable
- Google appeals the European Commission's DMA mandate to share search data Source : Search Engine Land
- Google Appeals Europe's DMA Mandate To Share Search History Data Source : Search Engine Roundtable
Google publiera les modifications suggérées sur votre fiche si vous laissez passer le délai
Google change sa façon de traiter les suggestions de modification sur les fiches d'établissement : passé un délai sans réponse du gestionnaire, la modification proposée par un tiers sera publiée. Le document de référence ajoute deux éléments que les comptes rendus ne reprennent pas : en cas d'abus répété du canal de signalement, toute réclamation ultérieure sera rejetée sans examen, et les comptes qui annulent automatiquement les suggestions s'exposent à une réduction de leur quota d'accès programmatique.
Qui reçoit ces notifications, concrètement ? Les adresses rattachées à la fiche, et une fiche peut compter plusieurs propriétaires et administrateurs. Si personne ne relève cette boîte, la modification passera, et vous découvrirez un horaire ou une catégorie modifiés des semaines plus tard.
Quelle conséquence pour un client multi-établissements ? Le traitement automatique des suggestions, courant chez les enseignes à réseau, devient risqué. Rejeter systématiquement par script expose au plafonnement de l'accès programmatique, c'est-à-dire à la perte du moyen même de gérer les fiches en masse.
- Google may publish suggested business edits if you miss its deadline Source : Search Engine Watch
- Google Business Profiles Policies Adds Misuse Of Support Channels Source : Search Engine Roundtable
Un média français affiche le modèle qui a rédigé ses résumés, Google en fait autant
Le Blog du Modérateur accompagne ses articles d'une mention explicite : le résumé a été généré par un modèle nommé, puis ajusté par un journaliste nommé. Le relevé porte sur quinze pages publiées dans la semaine. Au même moment, Google pose ses propres résumés générés par IA au-dessus de ses articles d'entreprise, avec trois formats au choix, une lecture audio, et la mention que ces résumés ont été produits par son IA. Nous l'avons vérifié page par page : la pratique n'est pas systématique, elle concerne une partie des publications.
Pourquoi s'arrêter sur une mention de bas de page ? Parce que c'est la première fois que deux éditeurs de ce niveau documentent publiquement non seulement l'usage d'une IA, mais le modèle employé et la personne qui a repris derrière. C'est un précédent utilisable tel quel : il donne une formulation à proposer à un client qui se demande comment assumer sa production assistée.
Faut-il l'adopter sur un blog d'entreprise ? Cela dépend de ce que vous vendez. Si votre promesse repose sur l'expertise d'une personne, nommer le modèle et le relecteur renforce la crédibilité plutôt qu'il ne l'abîme. Si votre contenu est entièrement produit sans relecture humaine, la mention révèle ce que vous préféreriez taire, et le problème n'est pas la mention.
- SEO : Google déploie une mise à jour de ses algorithmes Source : Blog du Modérateur
- Behind Project Suncatcher, our moonshot to put AI in space Source : blog.google
Un moteur français rouvre et n’ouvre ses pages aux robots d’IA que si elles sont payantes
Lycos.fr repart avec un index maison, construit par une personne seule. Le choix technique le plus intéressant n'est pas la taille de cet index mais la façon dont il traite les robots d'IA : GPTBot, ClaudeBot et PerplexityBot sont autorisés uniquement sur les pages payantes du service, tandis que les pages gratuites restent en non-indexation tout en laissant suivre les liens.
Pourquoi est-ce remarquable ? Parce que c'est la mise en pratique de ce que la rubrique sur les robots rend nécessaire : l'accès des IA traité comme une décision de périmètre, page par page, et non comme un interrupteur global. La plupart des sites que nous auditons n'ont jamais formulé cette décision, et la subissent donc telle que leur hébergeur l'a réglée.
Que transposer sur un site d'entreprise ? Le raisonnement plutôt que le réglage lui-même. Posez-vous la question par type de page : votre documentation publique gagne à être lue par les assistants, vos études chiffrées et vos pages de prestations peut-être moins, et vos contenus réservés aux clients certainement pas. Cette grille se construit en une réunion et se traduit en quelques lignes de configuration.
Le prix d'acquisition du nom de domaine est confirmé par une source indépendante. La taille de l'index annoncée ne repose, elle, que sur la déclaration de son fondateur.
- Lycos.fr : Benjamin Romei dévoile les coulisses de son moteur maison à 2,4 millions de sites Source : Abondance
- Lycos va chercher une seconde vie après le rachat du domaine Source : Blog du Modérateur
LinkedIn laisse enfin supprimer les faux employés de votre page entreprise
Les pages entreprise peuvent désormais retirer les profils qui se déclarent employés sans l'être. La fonction répond à un détournement courant : des comptes qui s'attachent à une marque connue pour crédibiliser une prospection, parfois frauduleuse.
Pourquoi est-ce un sujet de marque employeur et pas un détail ? Parce que le nombre d'employés affiché sur une page entreprise sert de signal de taille aux acheteurs et aux candidats. Une page gonflée par des profils fantômes donne une image fausse, et rend le vrai chiffre invérifiable.
Quoi d'autre bouge du côté du fil ? LinkedIn teste un fil limité aux publications de vos relations et de vos abonnements, sans recommandations algorithmiques. Si ce test se généralise, la portée des publications d'entreprise dépendra à nouveau de l'audience réellement acquise, ce qui remet la qualité des contenus devant la fréquence.
- LinkedIn : les pages entreprise peuvent enfin supprimer les faux employés Source : Blog du Modérateur
- LinkedIn teste un fil d'actualité limité aux relations et aux abonnements Source : Blog du Modérateur
Les chiffres-clés à retenir
- 48,6 % : part des blocs d'IA français qui se chargent après la page, sur un relevé de deux millions de pages de résultats du 9 au 14 septembre.
- 12 % : recouvrement des sources citées entre ChatGPT et Gemini, sur 161 286 requêtes.
- 4,8 % : recouvrement des domaines cités entre une interface de programmation et l'écran réel, chez ChatGPT, contre 26,7 % chez Perplexity.
- 5,2 % : part des sessions de conversation avec ChatGPT qui produisent un clic sortant, sur un panel d'ordinateurs américains.
- 112 dollars : prix médian réellement payé pour un lien, sur 22 703 placements, contre 508,95 dollars jugés acceptables par la profession.
- 0,4 % à 24,8 % : écart de la part du canal AI Assistant entre deux sites que nous mesurons dans Google Analytics.
- 101 blocs et 99 agents : taille du fichier robots.txt d'Amazon, qui n'a pas empêché l'agent d'achat de Meta d'opérer.
Retrouvez aussi mes dernières publications sur le LinkedIn de @Plume Numérique et de @Sandrine Lasserre
Les articles publiés cette semaine sur le blog de Plume Numérique
Voir tous les articles du blog
Retrouvez la revue de presse de la semaine précédente
Revue du digital – semaine du 21 septembre 2026

0 commentaire